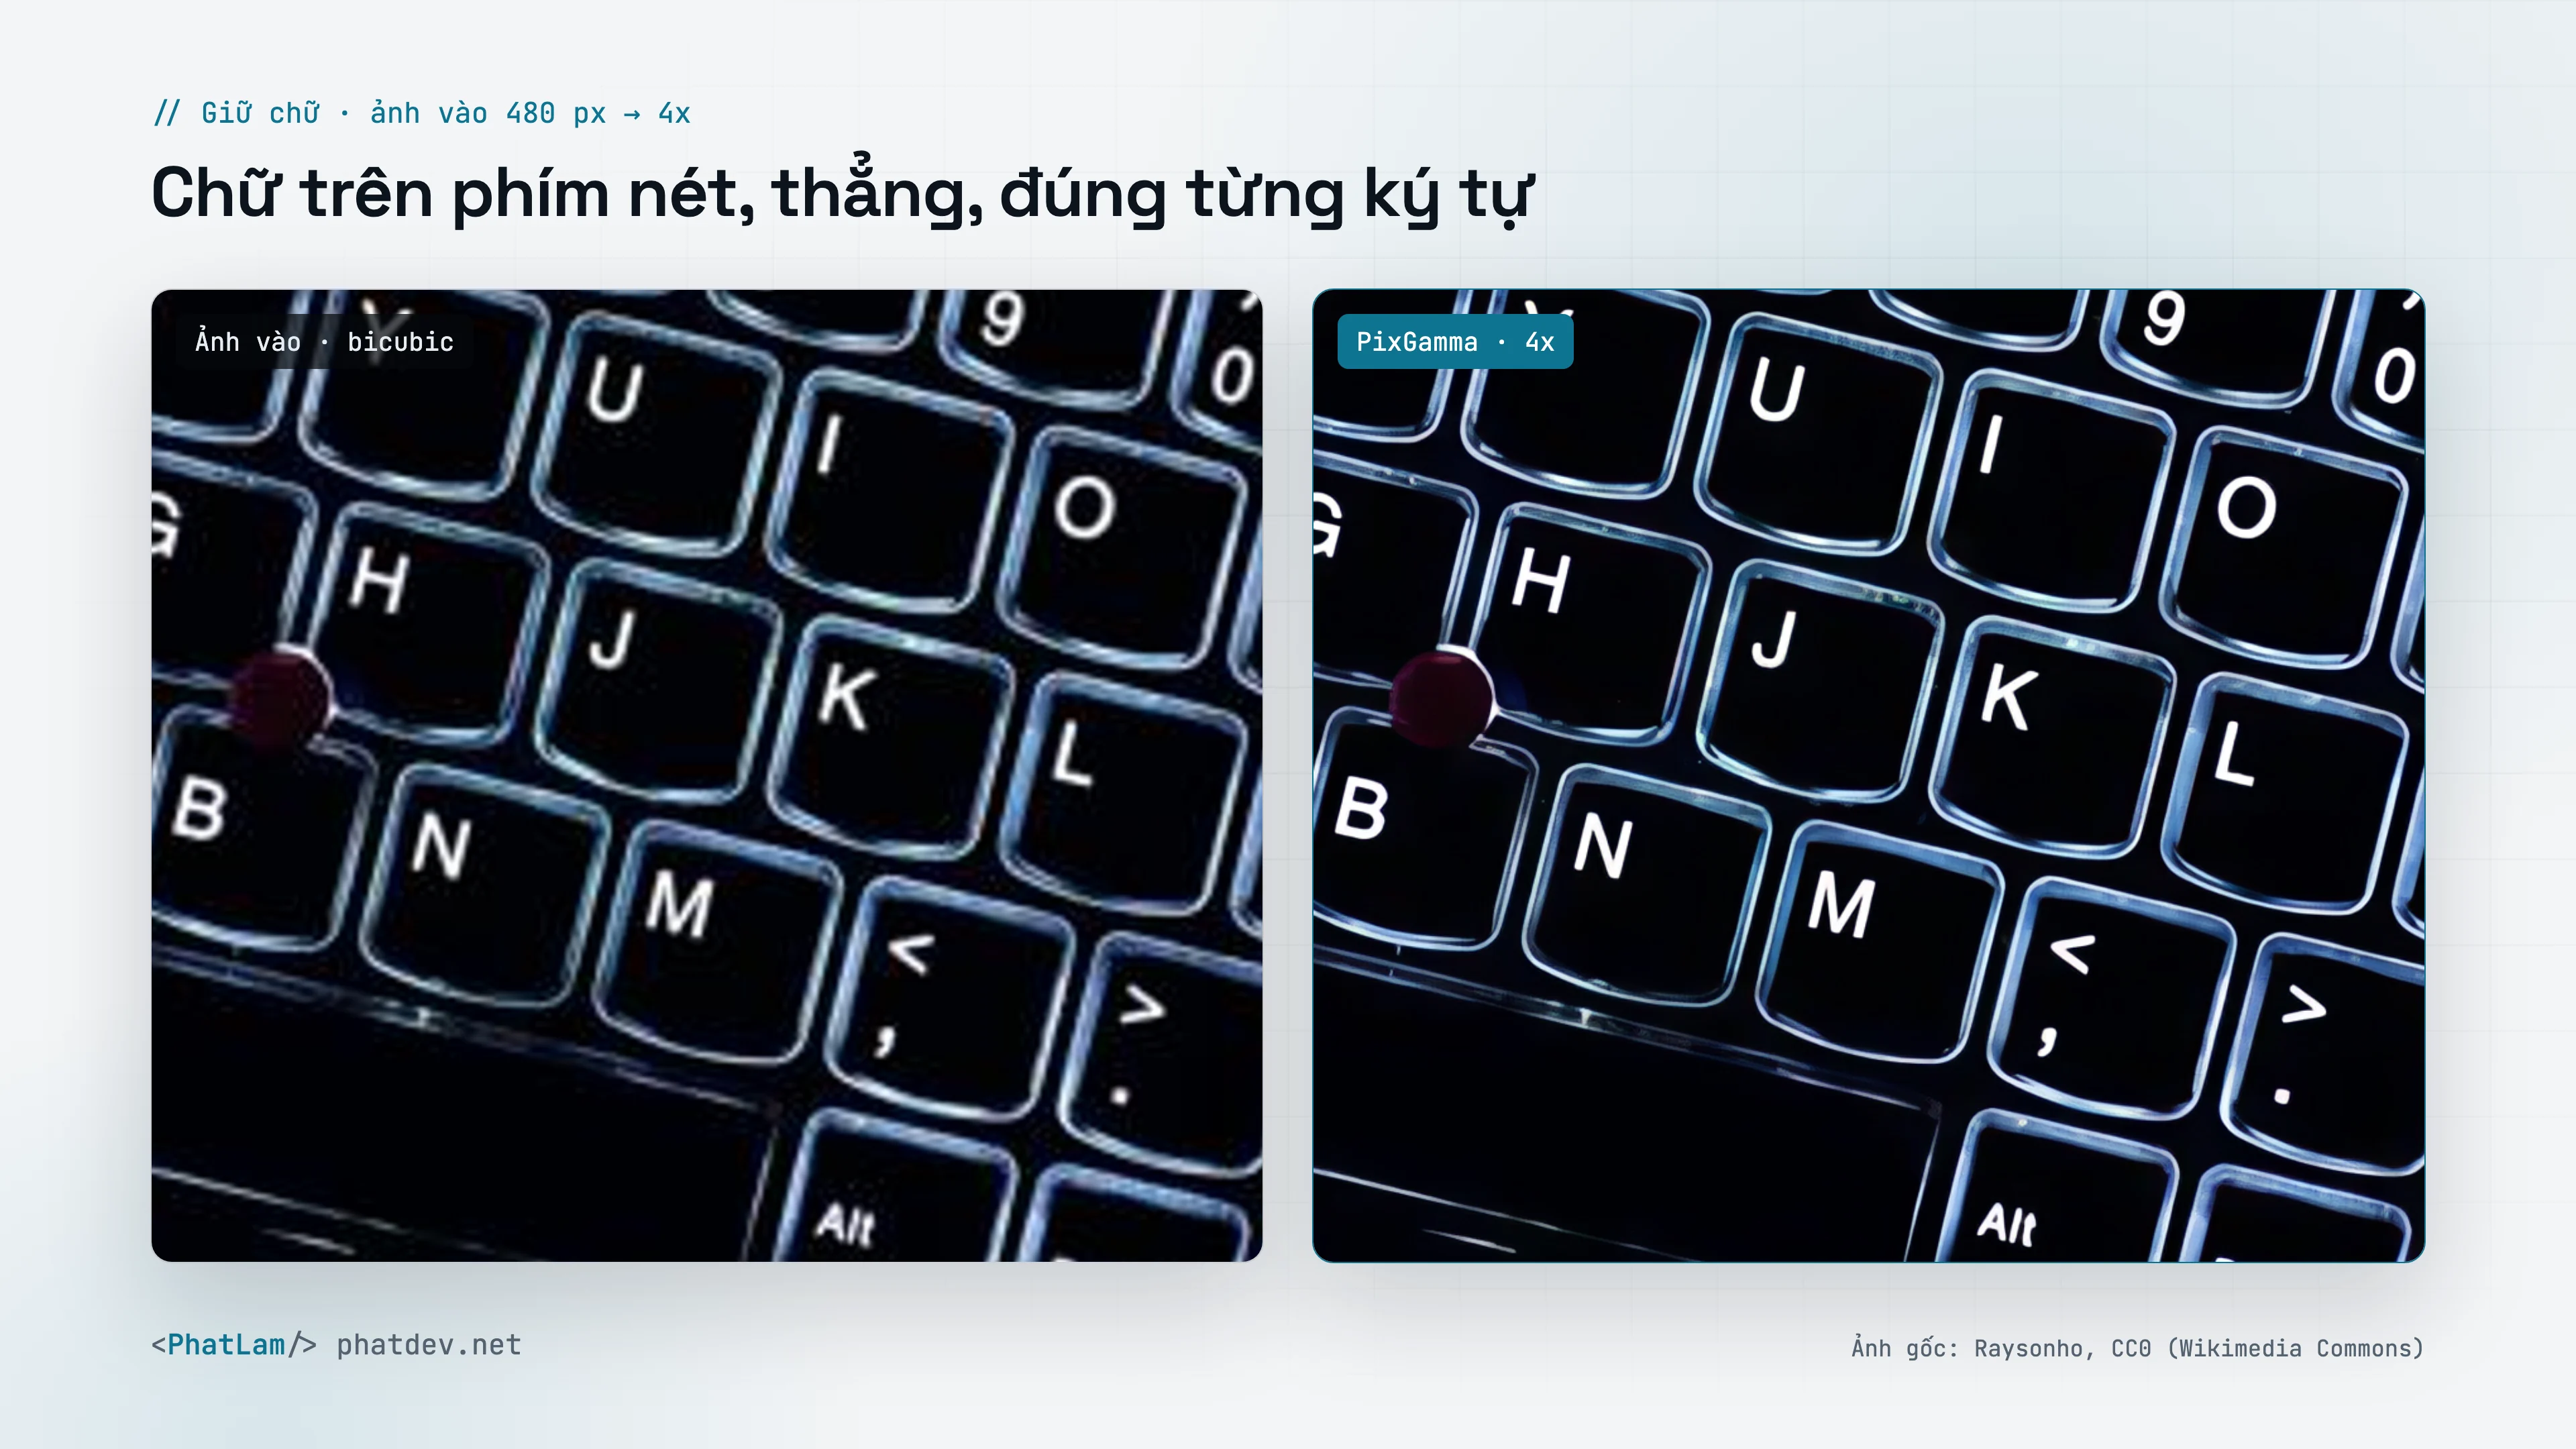
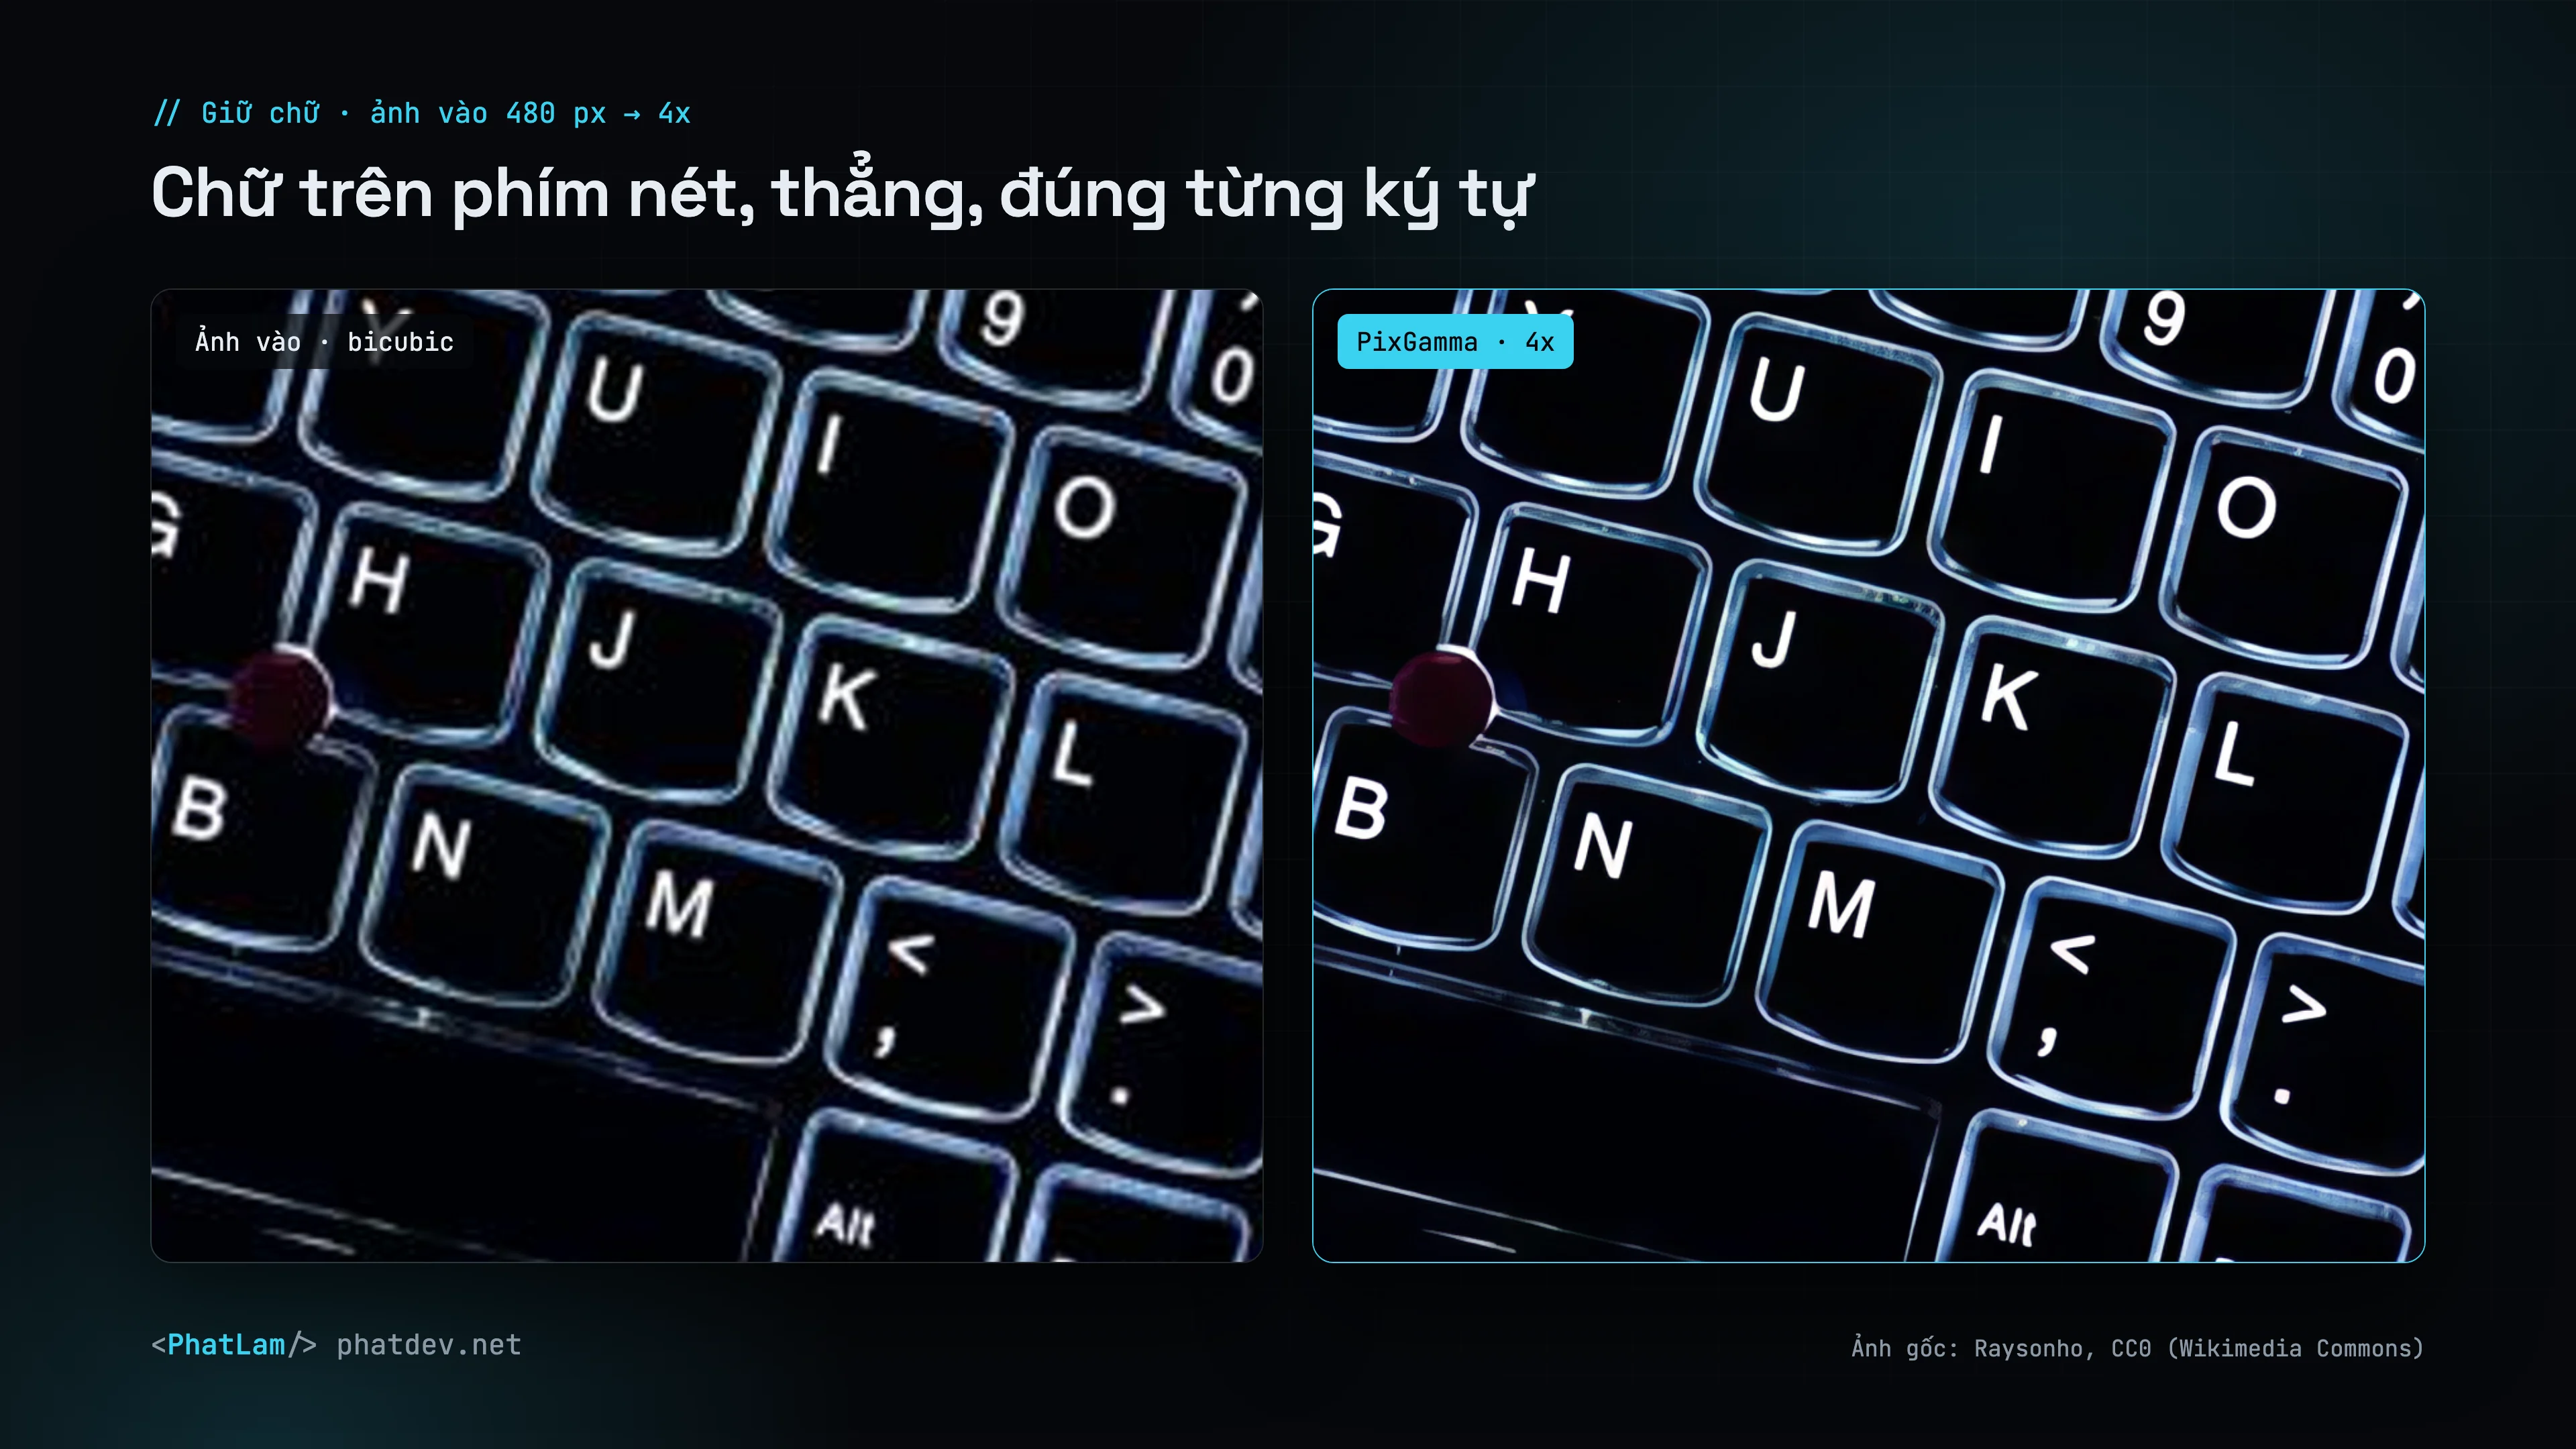
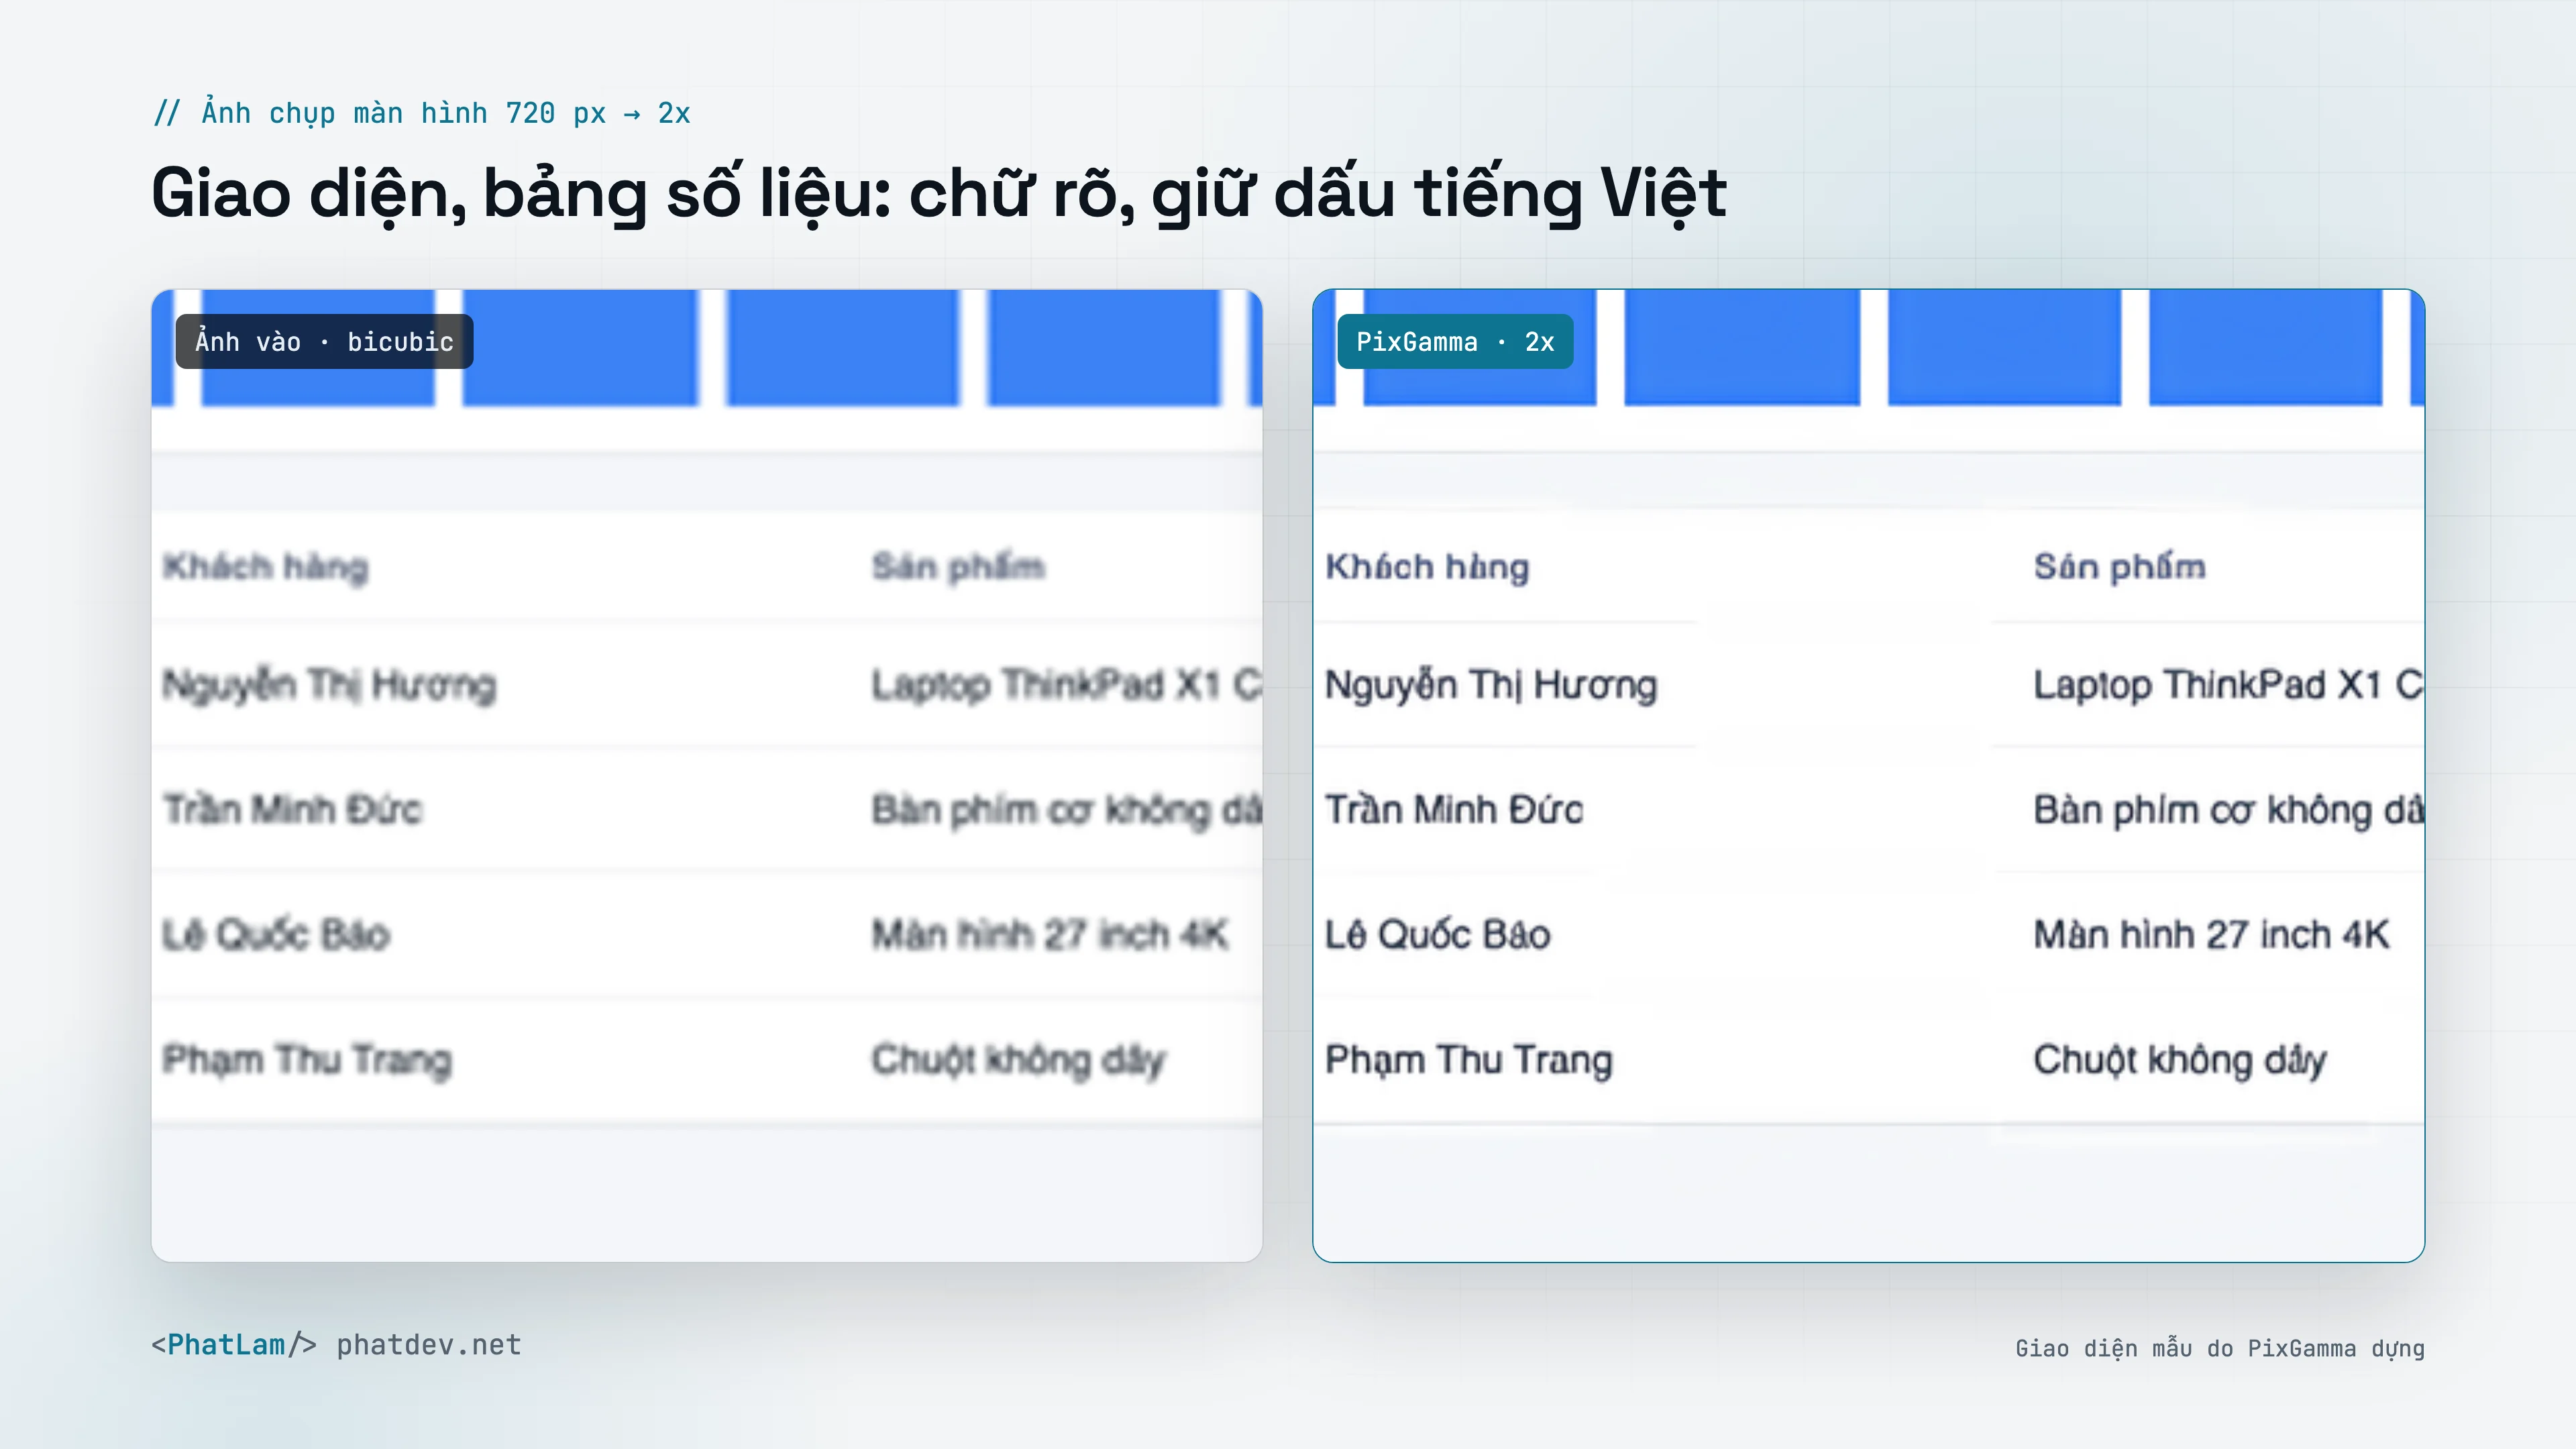
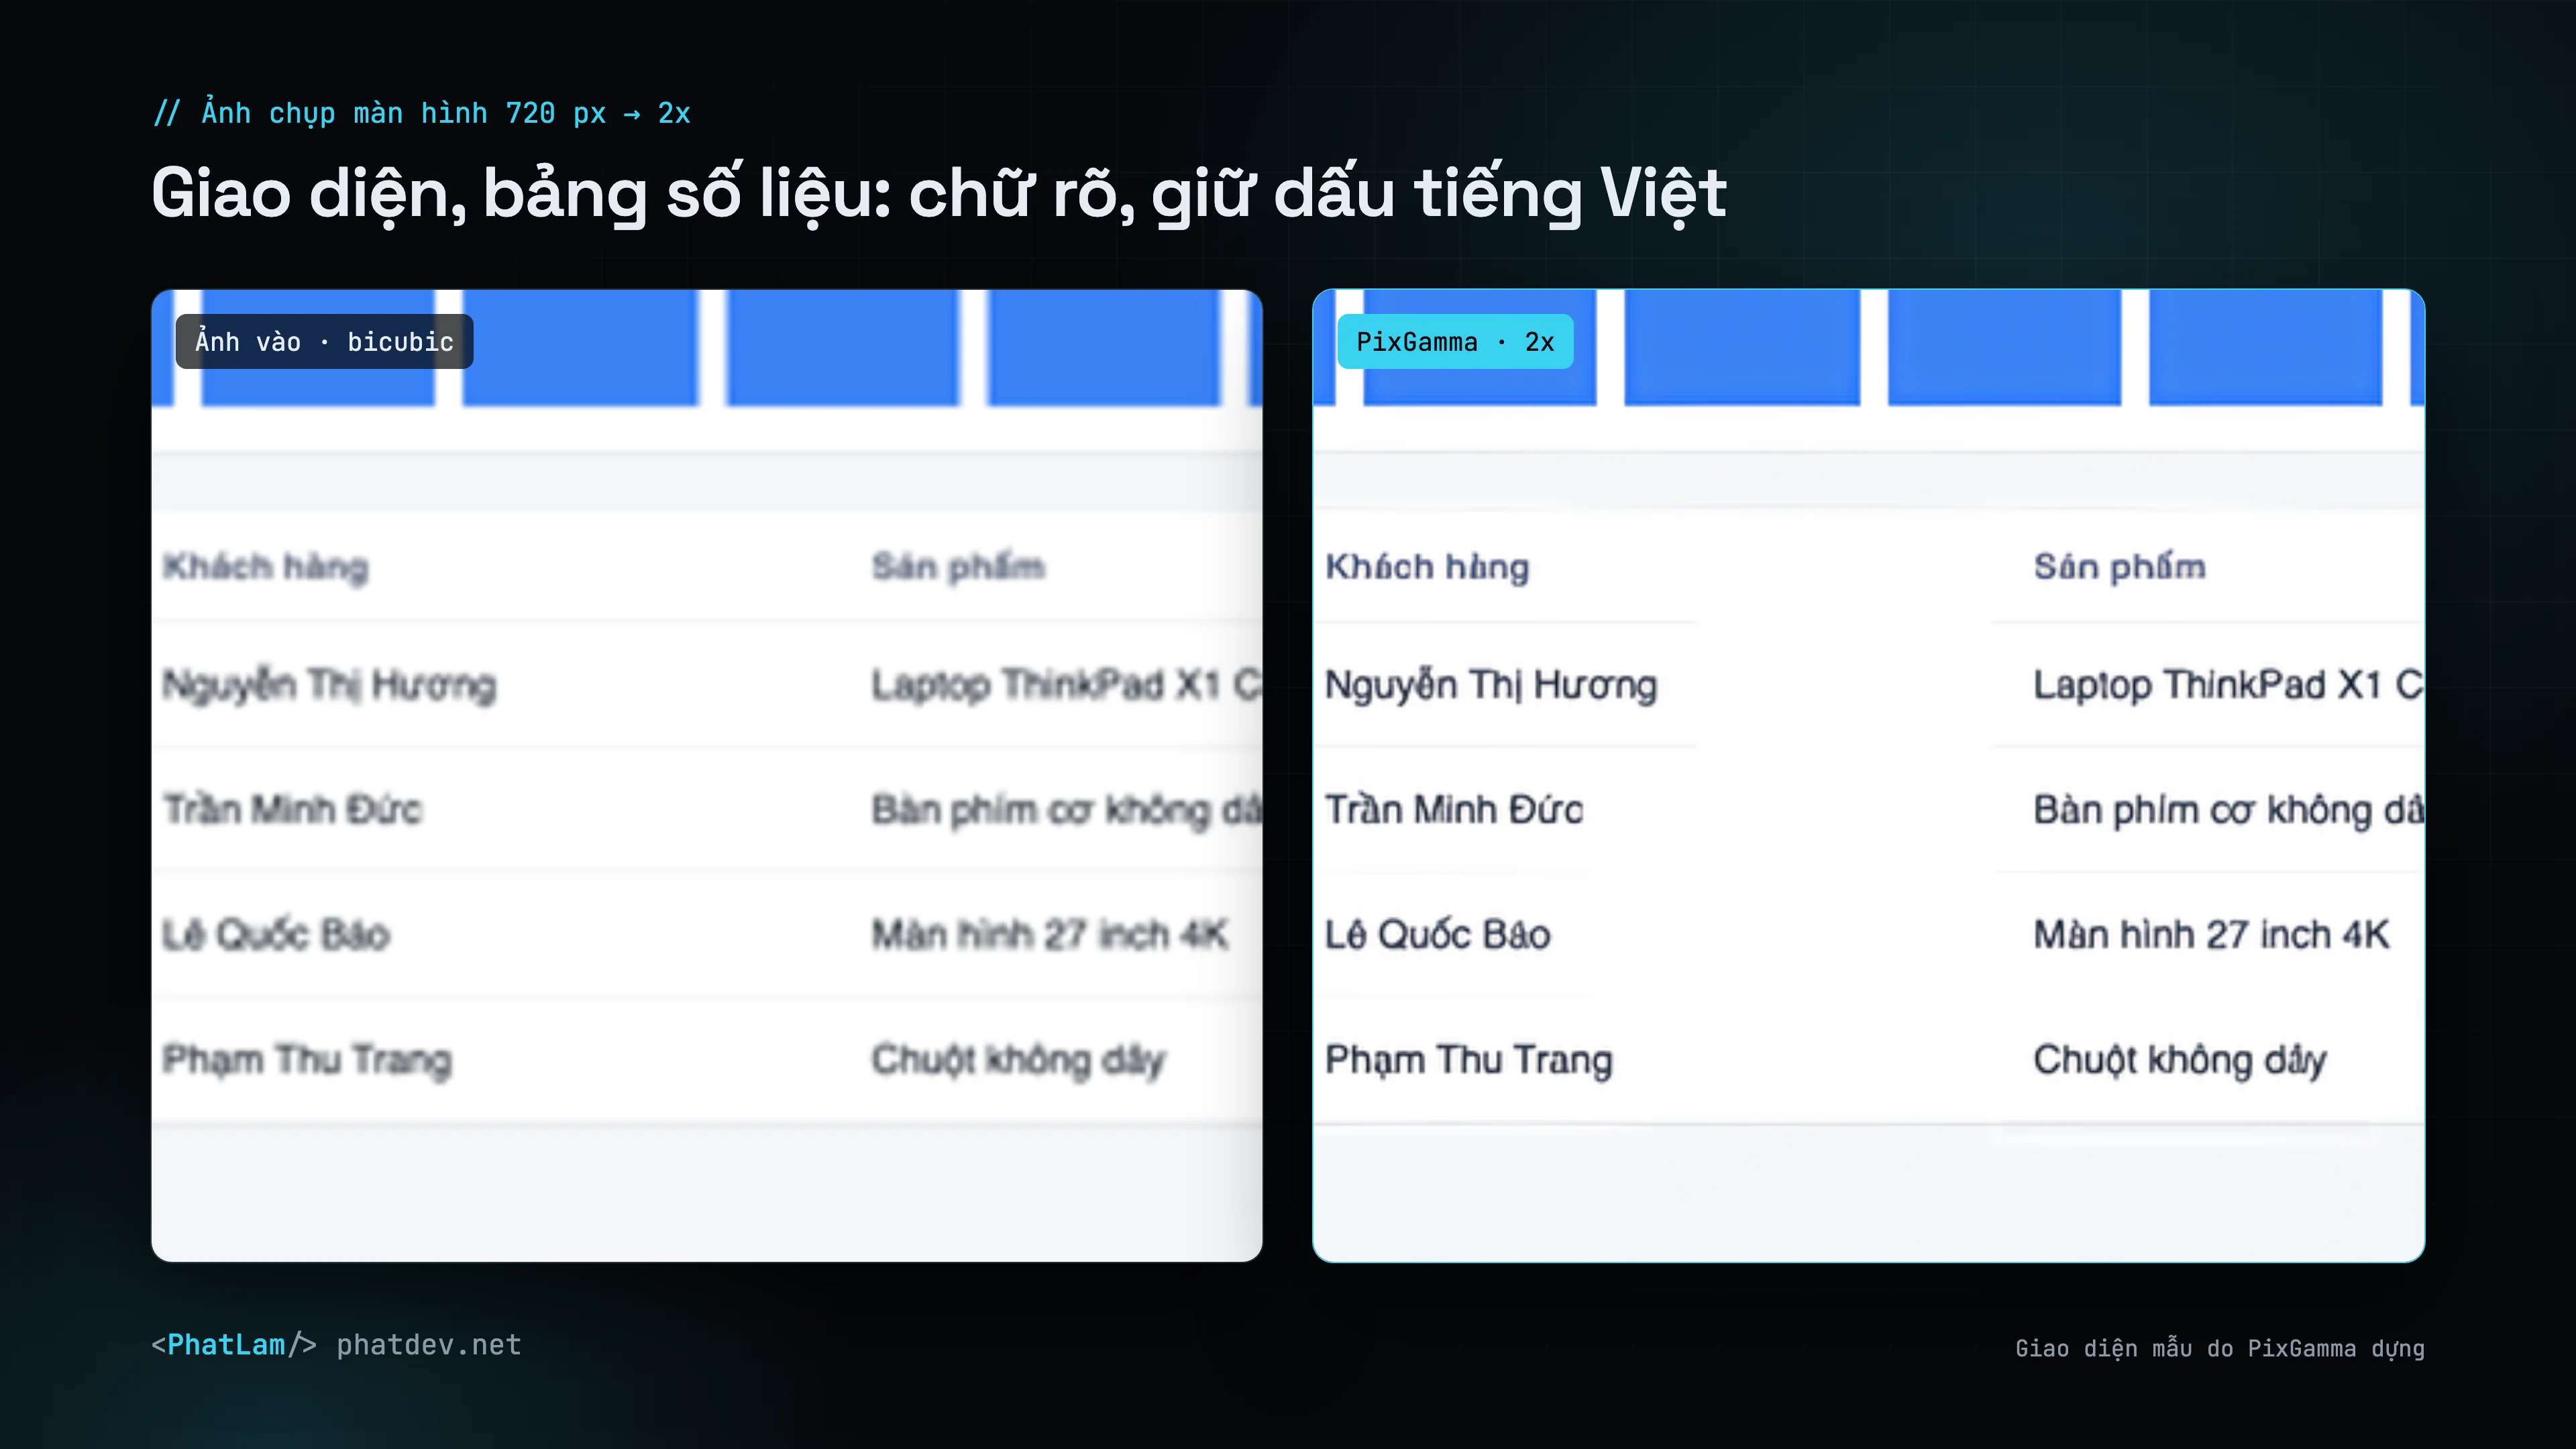
Chữ là chỗ AI phóng ảnh hay sai nhất: nét bị cong, chữ nhỏ bị vẽ thành chữ khác, dấu tiếng Việt rơi mất. PixGamma xử lý chữ bằng một bước riêng.
Cách làm
- Dò chữ. Apple Vision nhận diện chính xác với
vi-VTvàen-US, chạy trên ảnh gốc, trên ảnh phóng 2x và trên ảnh đã phóng để bắt được cả chữ nhỏ trên phím. Chữ đọc được ghi vào báo cáo (texttrong JSON). - Nối dòng. Vision hay dừng sớm vài chữ ở dòng chữ nhỏ; vùng chữ được nối dài theo mực chữ tới hết dòng.
- Đo cỡ từ điểm ảnh. Hộp chữ của Vision lệch 1–2 px ở chữ nhỏ, nên PixGamma đo độ trải dọc của mực chữ từng dòng ngay trên điểm ảnh.
- Dựng lại. Vùng chữ chạy lại bằng PixGamma Photo v1 (đã train cùng ô chữ), lấy trung bình 2 lượt (giữ nguyên và xoay 180°) để nét thẳng, rồi trộn mềm vào ảnh.
- Giữ màu chữ. Bước giữ màu gốc bỏ qua vùng chữ, nên chữ không bị phủ lại quầng nhoè từ ảnh nguồn.
Kết quả đo
Bộ chấm eval_text_pipeline.py dựng banner chữ Việt và Anh bằng nhiều font, thu nhỏ 4 lần rồi chạy cả quy trình; mỗi dòng được cắt riêng rồi đọc bằng OCR (Vision đọc một dòng khác đi tùy dòng bên cạnh, nên chấm cả banner sẽ nhiễu).
| Cách dựng vùng chữ | OCR đúng | PSNR | Độ nét |
|---|---|---|---|
| Không giữ chữ | 90,3% | 29,1 dB | 0,47 |
| Model Text v3 riêng (0.2.0) | 89,2% | 29,2 dB | 0,58 |
| PixGamma Photo v1, 2 lượt (0.2.1) | 91,1% | 30,5 dB | 0,69 |
Trên ảnh bàn phím MacBook thật thu nhỏ 4 lần: PSNR cả ảnh tăng từ 23,8 lên 25,1 dB, quanh chữ Y từ 19,5 lên 21,9 dB.
Chữ quá nhỏ
Ở chữ hoa khoảng 3,6 px trong ảnh gốc, dấu thanh tiếng Việt chưa tới 1 điểm ảnh. Model cũ vẽ ra chữ sắc nhưng sai, nên bản 0.2.0 chuyển các dòng này sang bản phóng mềm. PixGamma Photo v1 đọc đúng hơn cả bản phóng mềm ở cỡ này (76,1% so với 72,3%), nên từ 0.2.1 bước làm mềm chỉ còn áp dụng khi dùng model chữ cũ.
PixGamma từng thử dựng lại chữ nhỏ bằng font theo cách đọc của Vision và chỉ nhận khi khớp điểm ảnh, nhưng bỏ vì cách đọc sai khớp ảnh gần bằng cách đọc đúng.
Giới hạn đã biết: chữ mà Vision không dò ra được (ví dụ chữ thân bài dưới khoảng 4 px trên tấm biển trong ảnh bị thu nhỏ mạnh) thì không được giữ, và model phóng nào cũng có thể vẽ thành nét giống chữ. Với ảnh như vậy nên phóng 2x thay vì 4x, hoặc dùng High Fidelity.
Tắt giữ chữ
Trong app tắt ở bảng tinh chỉnh; CLI dùng --no-text-protect; API dùng text=0. Biến PIXGAMMA_TEXT_TTA=1|2|4|8 chọn số lượt lật/xoay, PIXGAMMA_TEXT_MODEL chọn model khác cho vùng chữ (để chấm điểm).