Bối cảnh
PixGamma là app macOS mình tự làm, không phải việc nhận từ khách. Nó nhận một tấm ảnh nhỏ, mờ hoặc đã bị nén, rồi trả lại bản lớn hơn từ 2 đến 16 lần, có lại chi tiết. Mọi thứ chạy trên chip Apple Silicon của chính máy Mac: không tài khoản, không máy chủ, ảnh không gửi đi đâu.
Mình làm vì hay phải phóng ảnh sản phẩm, ảnh chụp màn hình và ảnh cũ, mà công cụ có sẵn hay sai đúng chỗ mình cần nhất: chữ trên phím, chữ trên nhãn, chữ tiếng Việt có dấu. Bản 0.1.0 ra ngày 18/10/2026. Đến 30/10/2026, mã nguồn đã sang model ảnh thứ bảy và model chữ thứ ba. App từng tên Pixora, đổi thành PixGamma vì tên cũ trùng nhiều app chỉnh ảnh khác.
Phân vai: mình lên kế hoạch, định hướng chất lượng ảnh, chọn và huấn luyện model, kiểm thử và phát hành. Claude viết code theo kế hoạch và kiến trúc đó, Gemini (qua Antigravity) chỉnh giao diện, Codex review code và góp ý về lỗi.

Thách thức
Phóng ảnh bằng AI nghe đơn giản, nhưng có ba lỗi quen thuộc làm ảnh mất giá trị: chữ bị vẽ thành chữ khác, da, lông, vải bị phủ vân giả, và màu bị ngả. Thêm một điều nữa: nhiều công cụ đòi tải ảnh lên máy chủ của người khác.
Khó nhất là "đẹp" không đồng nghĩa với "đúng". Model nổi tiếng mình dùng làm gốc (UltraSharpV2) cho ảnh rất nét, nhưng phần lớn độ nét đó là phóng to luôn hạt nhiễu và khối nén của ảnh web. Nhìn thì thích, đặt cạnh ảnh gốc thì lệch. Mình cần một thước đo không dựa vào cảm giác. Thước đó là DISTS: điểm đo mức khác nhau về kết cấu giữa ảnh phóng và ảnh gốc, càng thấp càng giống ảnh gốc.
Ràng buộc thì có ba. Một người làm. Huấn luyện ngay trên máy Mac của mình. Và model gốc có giấy phép riêng: UltraSharpV2 chỉ cho dùng phi thương mại, nên PixGamma cũng miễn phí, phi thương mại và ghi công tác giả model gốc.
Cách làm
1. Dựng thước đo trước khi chọn model
Mình lập ba bộ chấm. Bộ thứ nhất là 40 ảnh web đã nén, chưa từng đưa vào huấn luyện. Bộ thứ hai là 25 vùng cắt lông vẹt, tóc, lông mày, môi và da. Bộ thứ ba là các dòng chữ Việt và Anh tự sinh, thu nhỏ 4 lần rồi để Apple Vision đọc lại từng dòng.
Luật đặt ra từ đầu: một model chỉ được vào app khi thắng bản đang dùng ở cả bộ chấm lẫn ảnh thật. Mình chấm 10 model 4x công khai trên bộ 40 ảnh. Real-ESRGAN x4plus được 0,186, UltraSharpV2 được 0,177, và model mạnh nhất lúc đó (4xBHI_dat2_real) được 0,173.
2. Huấn luyện lại ngay trên Mac
Từ model 0,173 đó, mình huấn luyện thêm 15.000 vòng bằng GPU của Mac rồi chuyển sang Core ML (định dạng chạy AI của Apple). Không dùng GAN, kỹ thuật hay sinh thêm vân giả, để model không bịa chi tiết. Bản này tên PixGamma Photo v1: DISTS 0,165, độ sát điểm ảnh (PSNR) 30,5 dB so với 29,0 dB của bản gốc, màu gần như không lệch.
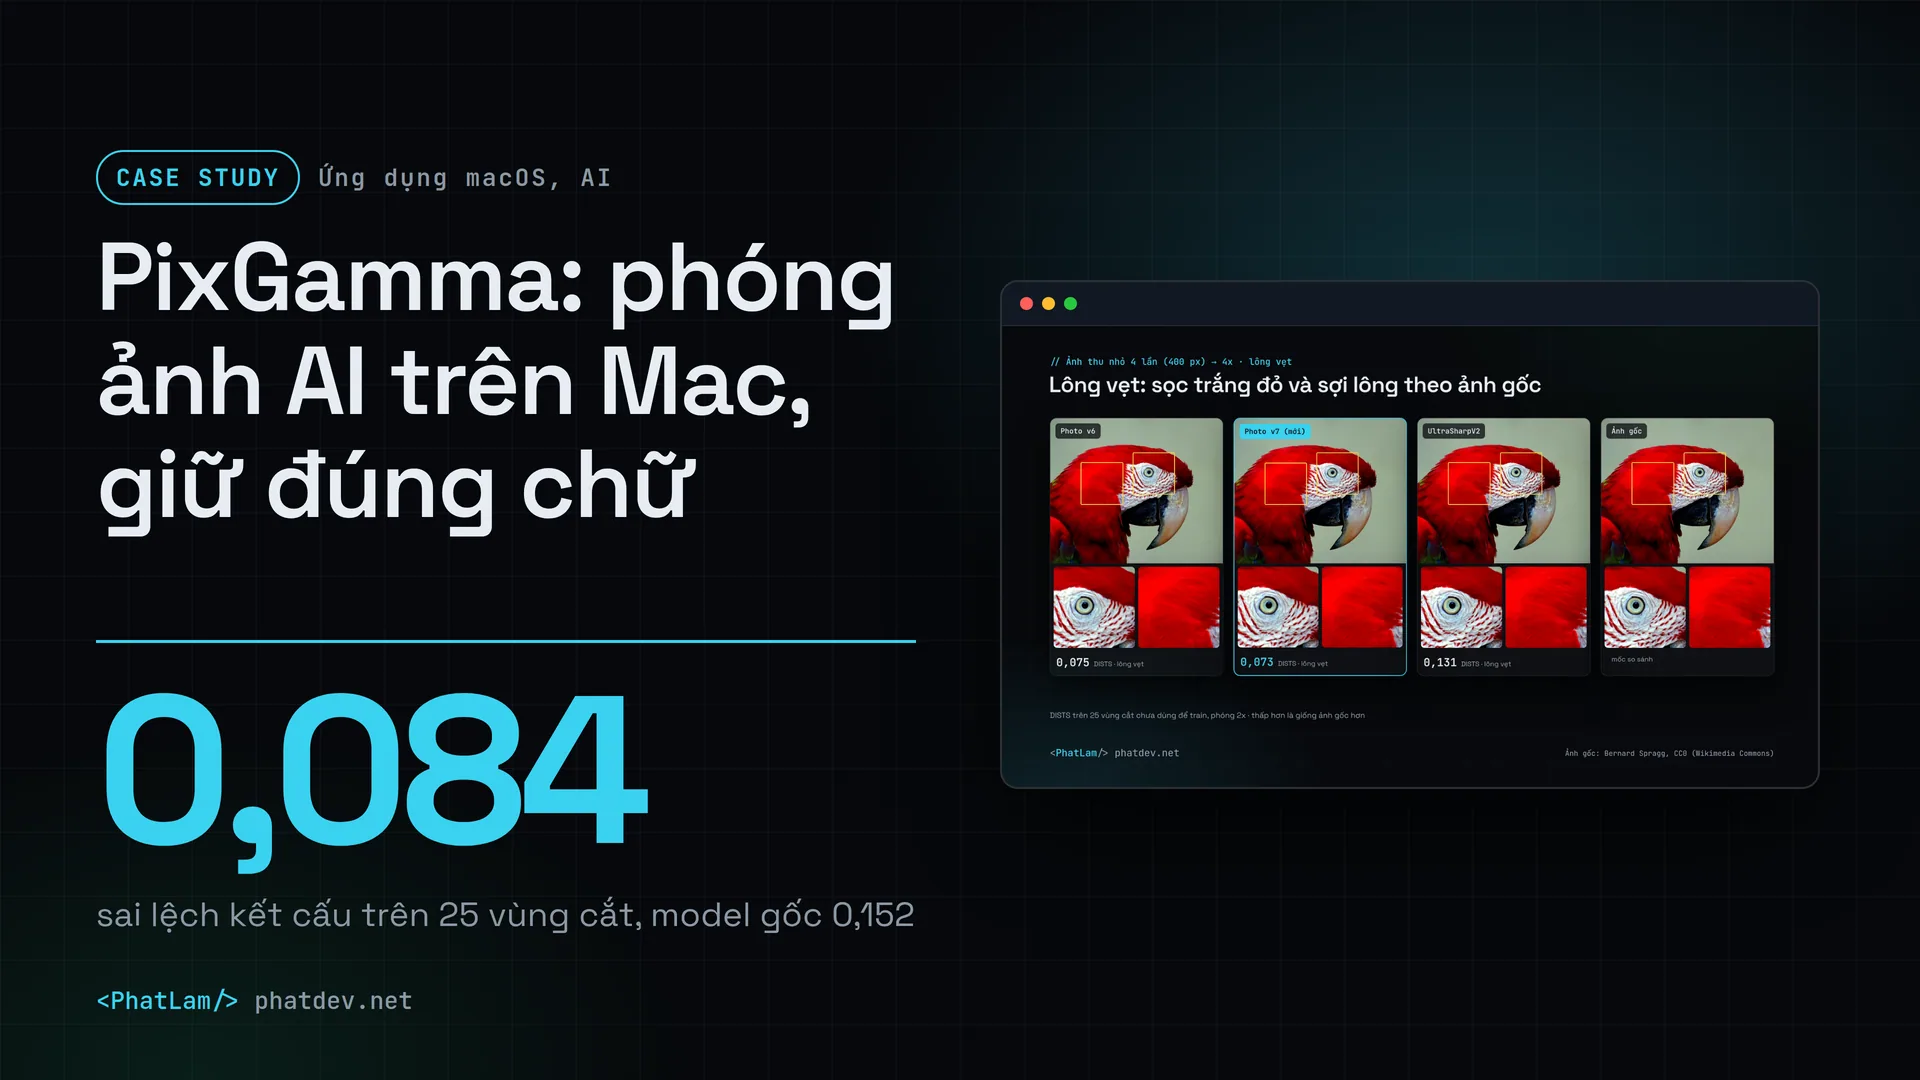
Sau đó mình đổi sang UltraSharpV2 làm gốc và huấn luyện thêm trên ảnh cận cảnh lông chim, tóc, da. Trên bộ 25 vùng cắt ở 2x, điểm đi từ 0,152 của UltraSharpV2 xuống 0,099 (v3), 0,094 (v4), 0,090 (v6) và 0,084 (v7). Cái giá là độ sát điểm ảnh giảm một chút: chi tiết rõ hơn thì phải chấp nhận lệch điểm ảnh nhiều hơn.
3. Giữ chữ bằng một quy trình riêng
Chữ là chỗ AI phóng ảnh hay sai nhất, nên mình tách nó ra khỏi ảnh nền. Apple Vision tìm chữ, vùng chữ được đo lại từ điểm ảnh, dựng lại bằng một model huấn luyện riêng cho chữ, rồi trộn mềm vào ảnh. Nếu chữ nhỏ hoặc nhiễu đến mức không dựng đúng được, app giữ bản phóng trung thực chứ không vẽ thành chữ khác.

Bộ chấm chữ từng làm mình hết hồn. Chỉ dịch ảnh 1 đến 3 điểm ảnh mà điểm chữ có dấu chênh tới 6 điểm, và một font thử nghiệm không có chữ tiếng Việt nên ảnh gốc hiện ô vuông. Mình đổi sang lấy trung bình trên 8 cách dịch ảnh và thay font đó. Từ đó con số mới đáng tin.
4. Cái nào thua thì bỏ, và ghi lại
Có những bản mình tưởng sẽ thắng mà thua. Photo v5 lấy gốc 4xNomos2_hq_dat2 thua v4 ở hầu hết bài chấm. Model chữ có thêm nét mảnh (Text v4) nét hơn nhưng đọc chữ hoa 4,3 px kém hơn. Hướng đọc chữ bằng OCR rồi vẽ lại bằng font bị bỏ vì đổi cả kiểu chữ so với ảnh gốc.
Có một bài học riêng từ 4xNomos2_hq_dat2: nó giống ảnh gốc nhất ở ảnh sạch 2x (0,072) nhưng tệ ở ảnh web đã nén (0,245 so với 0,172 của Photo v7). Một con số đẹp trên một bộ chấm không đủ để chọn model.
5. Đóng gói để dùng hằng ngày
App cài bằng file DMG, tự cập nhật từ GitHub, kiểm tra mã SHA-256 và có đường lùi nếu bản mới hỏng. Có lệnh pixgamma để xử lý cả thư mục và in báo cáo JSON, cùng một HTTP API chỉ chạy trên máy để nối vào script. Chế độ Recover dùng diffusion để tái tạo da, tóc, lông, tải riêng vì nặng khoảng 2,7 GB.
Đường phóng 2x cũng đổi: chạy model 4x rồi thu nhỏ về một nửa. Trên 8 ảnh sạch, cách này cho 35,4 dB và độ nét 0,96 so với ảnh gốc, so với 34,5 dB và 0,70 của model 2x riêng. Đổi lại chậm hơn khoảng 2 lần.
Một lỗi mình suýt để lọt: xuất ảnh vào chính thư mục chứa ảnh gốc thì file ra trùng tên và ghi đè mất ảnh gốc. Bản mã nguồn mới nhất đã thêm hậu tố -pixgamma khi trùng tên, cả trong app lẫn dòng lệnh.
Kết quả
Các số dưới đây đo bằng bộ chấm của chính dự án, trên ảnh CC0 và public domain từ Wikimedia Commons chưa dùng để huấn luyện. Chúng không phải khảo sát người dùng. Model ảnh v7 đo ngày 28/10/2026, model chữ v3 ngày 30/10/2026, banner của bản 0.2.1 ngày 20/10/2026.
Cột xám là UltraSharpV2, model công khai dùng làm gốc. Cột xanh là PixGamma Photo v7. Đo ngày 28/10/2026 bằng bộ chấm của dự án: ảnh được thu nhỏ rồi phóng lại, so với ảnh gốc, ảnh CC0 và public domain chưa dùng để huấn luyện. DISTS không phải thước đo duy nhất: phóng thường (bicubic) được 0,140 ở bộ đầu vì nó làm mềm, nên mình còn đo độ chi tiết (v7 0,90, UltraSharpV2 1,31, ảnh gốc là 1,0).
Apple Vision đọc từng dòng chữ tự sinh bằng vài font phổ biến, sau khi thu nhỏ 4 lần và chạy cả quy trình phóng 4x. Hàng đầu đo ngày 20/10/2026; hai hàng sau đo ngày 30/10/2026 trên 40 dòng, lấy trung bình 8 cách dịch ảnh. Hai bộ đo khác cách chấm nên không so các hàng với nhau. Giới hạn: đây là chữ tự sinh, không phải ảnh chụp thật.
Ở bộ lông, tóc, da, PixGamma v7 đạt 0,084 so với 0,152 của model gốc. Mình cũng đo "độ chi tiết" so với ảnh gốc, trong đó 1,0 là bằng ảnh gốc: v7 được 0,90, còn UltraSharpV2 được 1,31, tức là thêm cả hạt và khối nén. Ở ảnh web đã nén phóng 4x thì kết quả gần hòa: 0,164 so với 0,177.
Với chữ, bản 0.2.1 đọc đúng 91,1% ký tự trên banner chữ Việt và Anh sau khi phóng 4x. Con số này nhích ít so với 90,3% khi không giữ chữ, nhưng nét chữ thẳng hơn rõ: độ nét đi từ 0,47 lên 0,69 và PSNR từ 29,1 lên 30,5 dB. Bản Text v3 mới hơn đưa tỉ lệ đọc đúng lên 92,4%, riêng chữ có dấu lên 78,8%.

Có hai điều mình chưa làm được. Chữ rất nhỏ vẫn là điểm yếu: khi chữ hoa chỉ cao khoảng 3,6 px trong ảnh gốc, dấu thanh tiếng Việt chưa tới 1 điểm ảnh, và chữ mà Apple Vision không dò ra thì không được bảo vệ. Và Photo v7 cùng Text v3 đã có trên GitHub nhưng chưa đóng thành bản cài: bản cài mới nhất vẫn là 0.2.1, ngày 20/10/2026.
Bài học
Chọn thước đo trước, chọn model sau. Không có bộ chấm thì "nét" đánh lừa mình, và model nét nhất hóa ra là model thêm nhiễu nhiều nhất.
Một con số không đủ. DISTS thấp hơn ở một bộ ảnh không có nghĩa là tốt hơn ở bộ khác, nên mỗi model phải qua cả bộ chấm lẫn ảnh thật.
Bộ chấm cũng có lỗi. Khi điểm chữ nhảy 6 điểm chỉ vì dịch ảnh vài điểm ảnh, việc đầu tiên là sửa cách đo, không phải sửa model.
Ghi lại cả bản bị bỏ. Bảng "đã thử nhưng không dùng" trong tài liệu giúp mình không thử lại hướng đã chết sau vài tuần.
Giấy phép của model gốc quyết định cách phát hành. Vì UltraSharpV2 chỉ cho dùng phi thương mại, PixGamma miễn phí, phi thương mại, và đó là chuyện cần biết từ ngày chọn model, không phải ngày phát hành.
Cần việc tương tự?
Nếu bạn muốn chạy một model AI ngay trên máy của mình hay của khách để dữ liệu không đi đâu, hoặc cần ai đó đo và chọn model cho một việc cụ thể như ảnh, chữ, giọng nói, gửi mình vài dòng. Mình sẽ dựng bộ chấm bằng dữ liệu của bạn trước, rồi mới nói nên dùng model nào và vì sao.