---
title: "Model riêng & huấn luyện"
url: https://phatdev.net/docs/pixgamma/model-rieng
lang: vi
updated: 2026-10-22
alternate:
en: https://phatdev.net/en/docs/pixgamma/model-rieng
markdown: https://phatdev.net/docs/pixgamma/model-rieng.md
---
# Model riêng & huấn luyện
Thuộc bộ tài liệu: [PixGamma](https://phatdev.net/docs/pixgamma.md)
> PixGamma Photo v2 và v1, bảng chấm 10 model công khai, các bản đã thử và bộ công cụ huấn luyện.
PixGamma có model riêng, huấn luyện ngay trên Mac bằng [traiNNer-redux](https://github.com/the-database/traiNNer-redux) chạy GPU (MPS), rồi chuyển sang Core ML. Mỗi model chỉ được đưa vào app khi thắng bản đang dùng ở **cả hai bài chấm**: bộ ảnh chấm điểm và chạy cả quy trình trên ảnh thật.
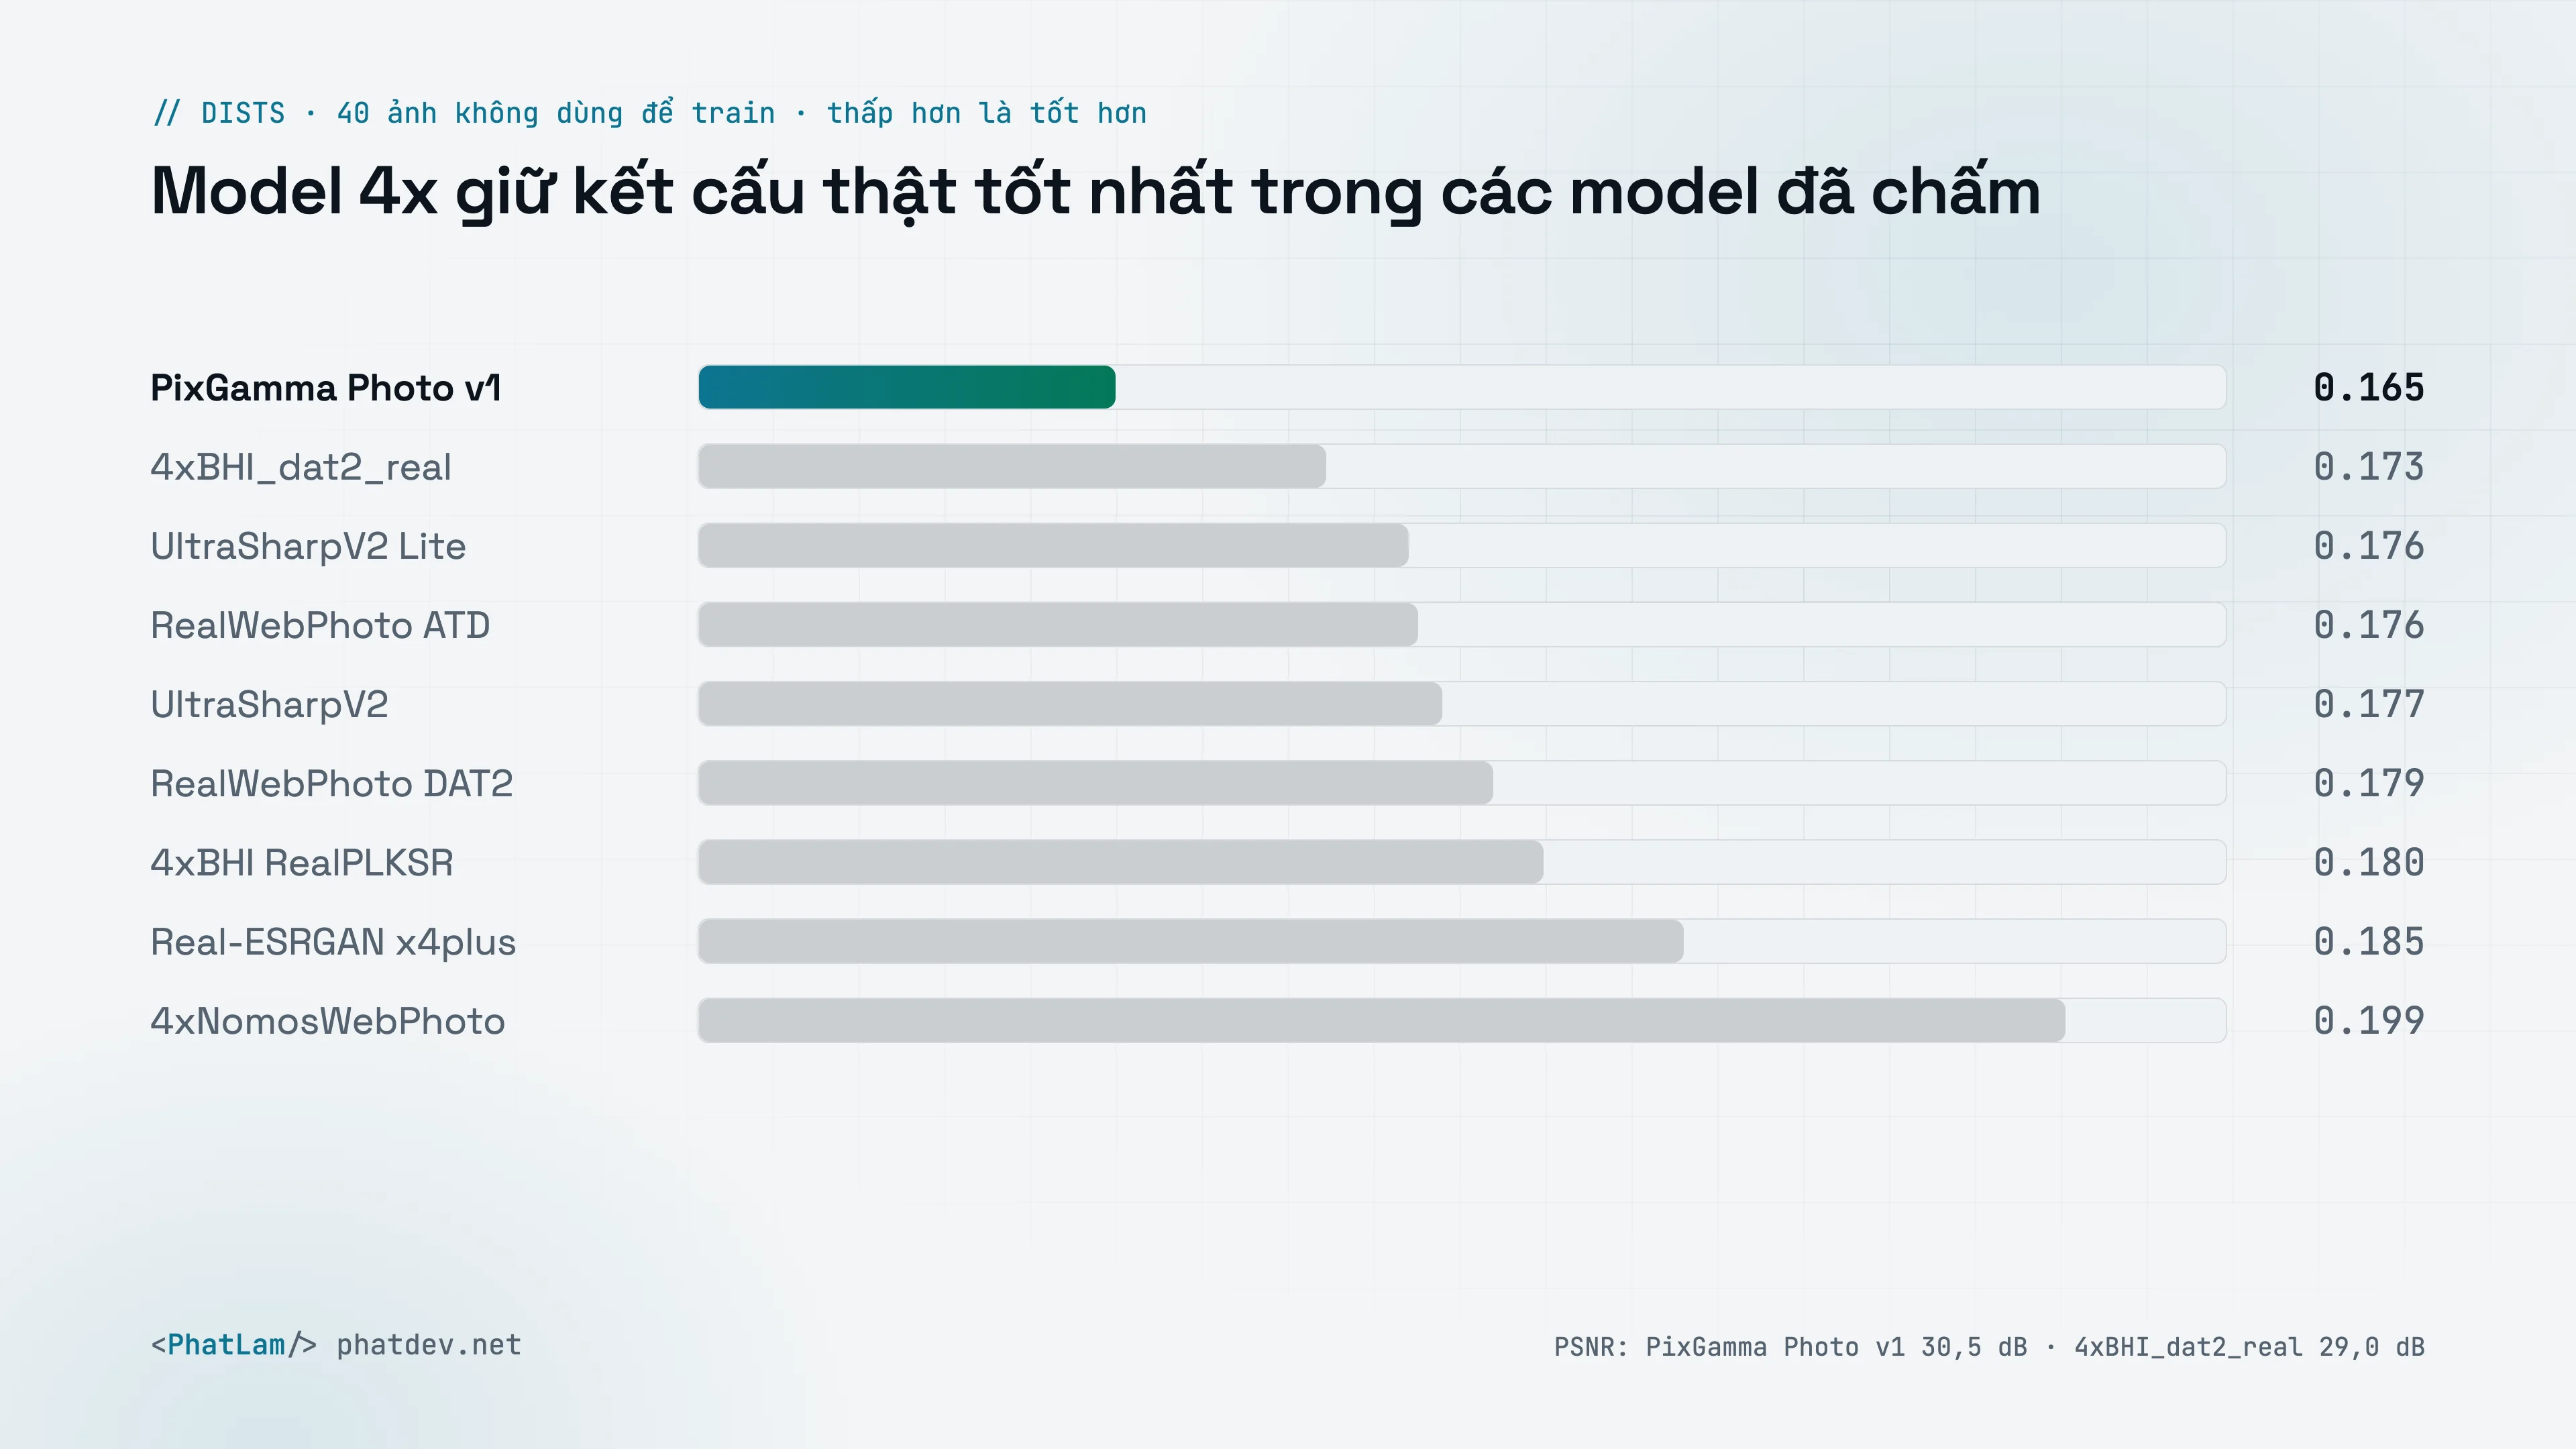
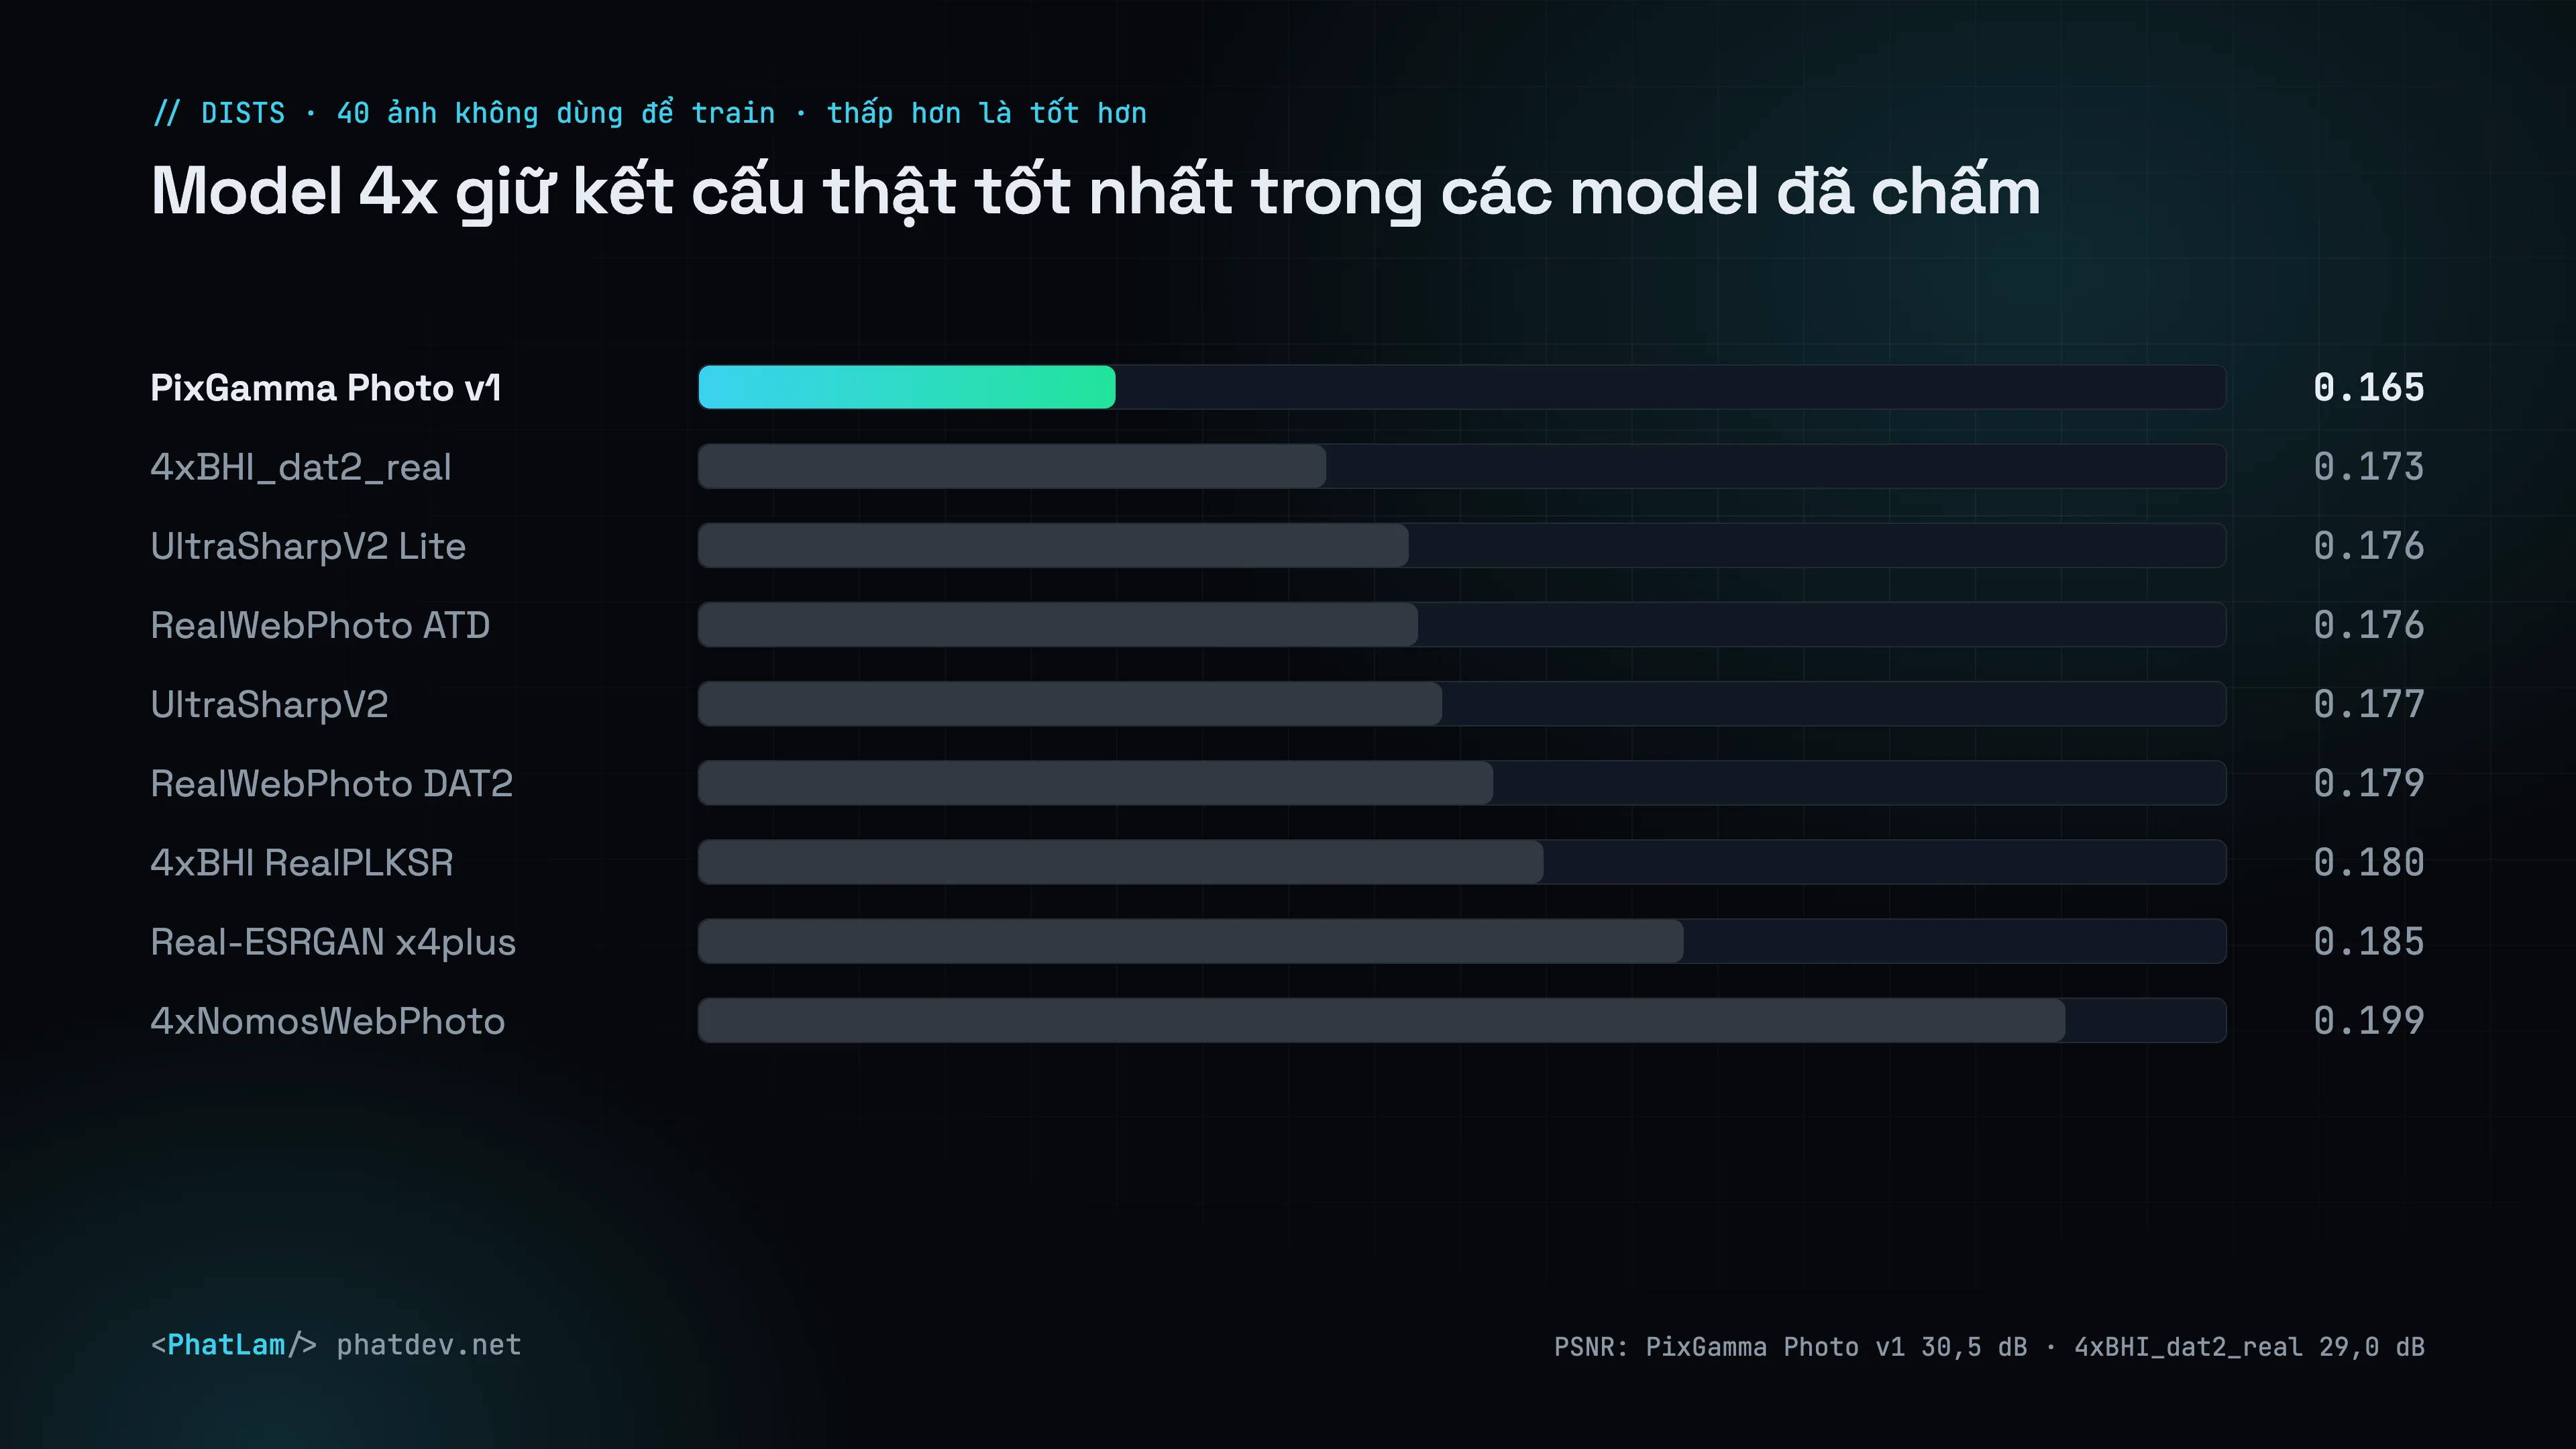
DISTS trên 40 ảnh không dùng để train: PixGamma Photo v1 so với 9 model công khai
## Chọn model gốc
PixGamma chấm 10 model 4x công khai được đánh giá cao (Hugging Face, OpenModelDB, GitHub) trên 40 ảnh không dùng để train: 22 ảnh laptop, chân dung, động vật, vải, da. Chỉ số chính là **DISTS** (độ giống kết cấu, càng thấp càng tốt) và PSNR.
| Model 4x | DISTS |
|---|---|
| **PixGamma Photo v2** | **0,164** |
| PixGamma Photo v1 | 0,165 |
| 4xBHI_dat2_real (gốc của Photo v1) | 0,173 |
| UltraSharpV2 Lite | 0,176 |
| RealWebPhoto ATD | 0,176 |
| UltraSharpV2 | 0,177 |
| RealWebPhoto DAT2 | 0,179 |
| 4xBHI RealPLKSR | 0,180 |
| Real-ESRGAN x4plus | 0,186 |
| 4xNomosWebPhoto (model Photo bản 0.1) | 0,199 |
PSNR trên cùng bộ ảnh: PixGamma Photo v1 30,5 dB, 4xBHI_dat2_real 29,0 dB, 4xNomosWebPhoto 26,9 dB.
## PixGamma Photo v2 (model ảnh mặc định)
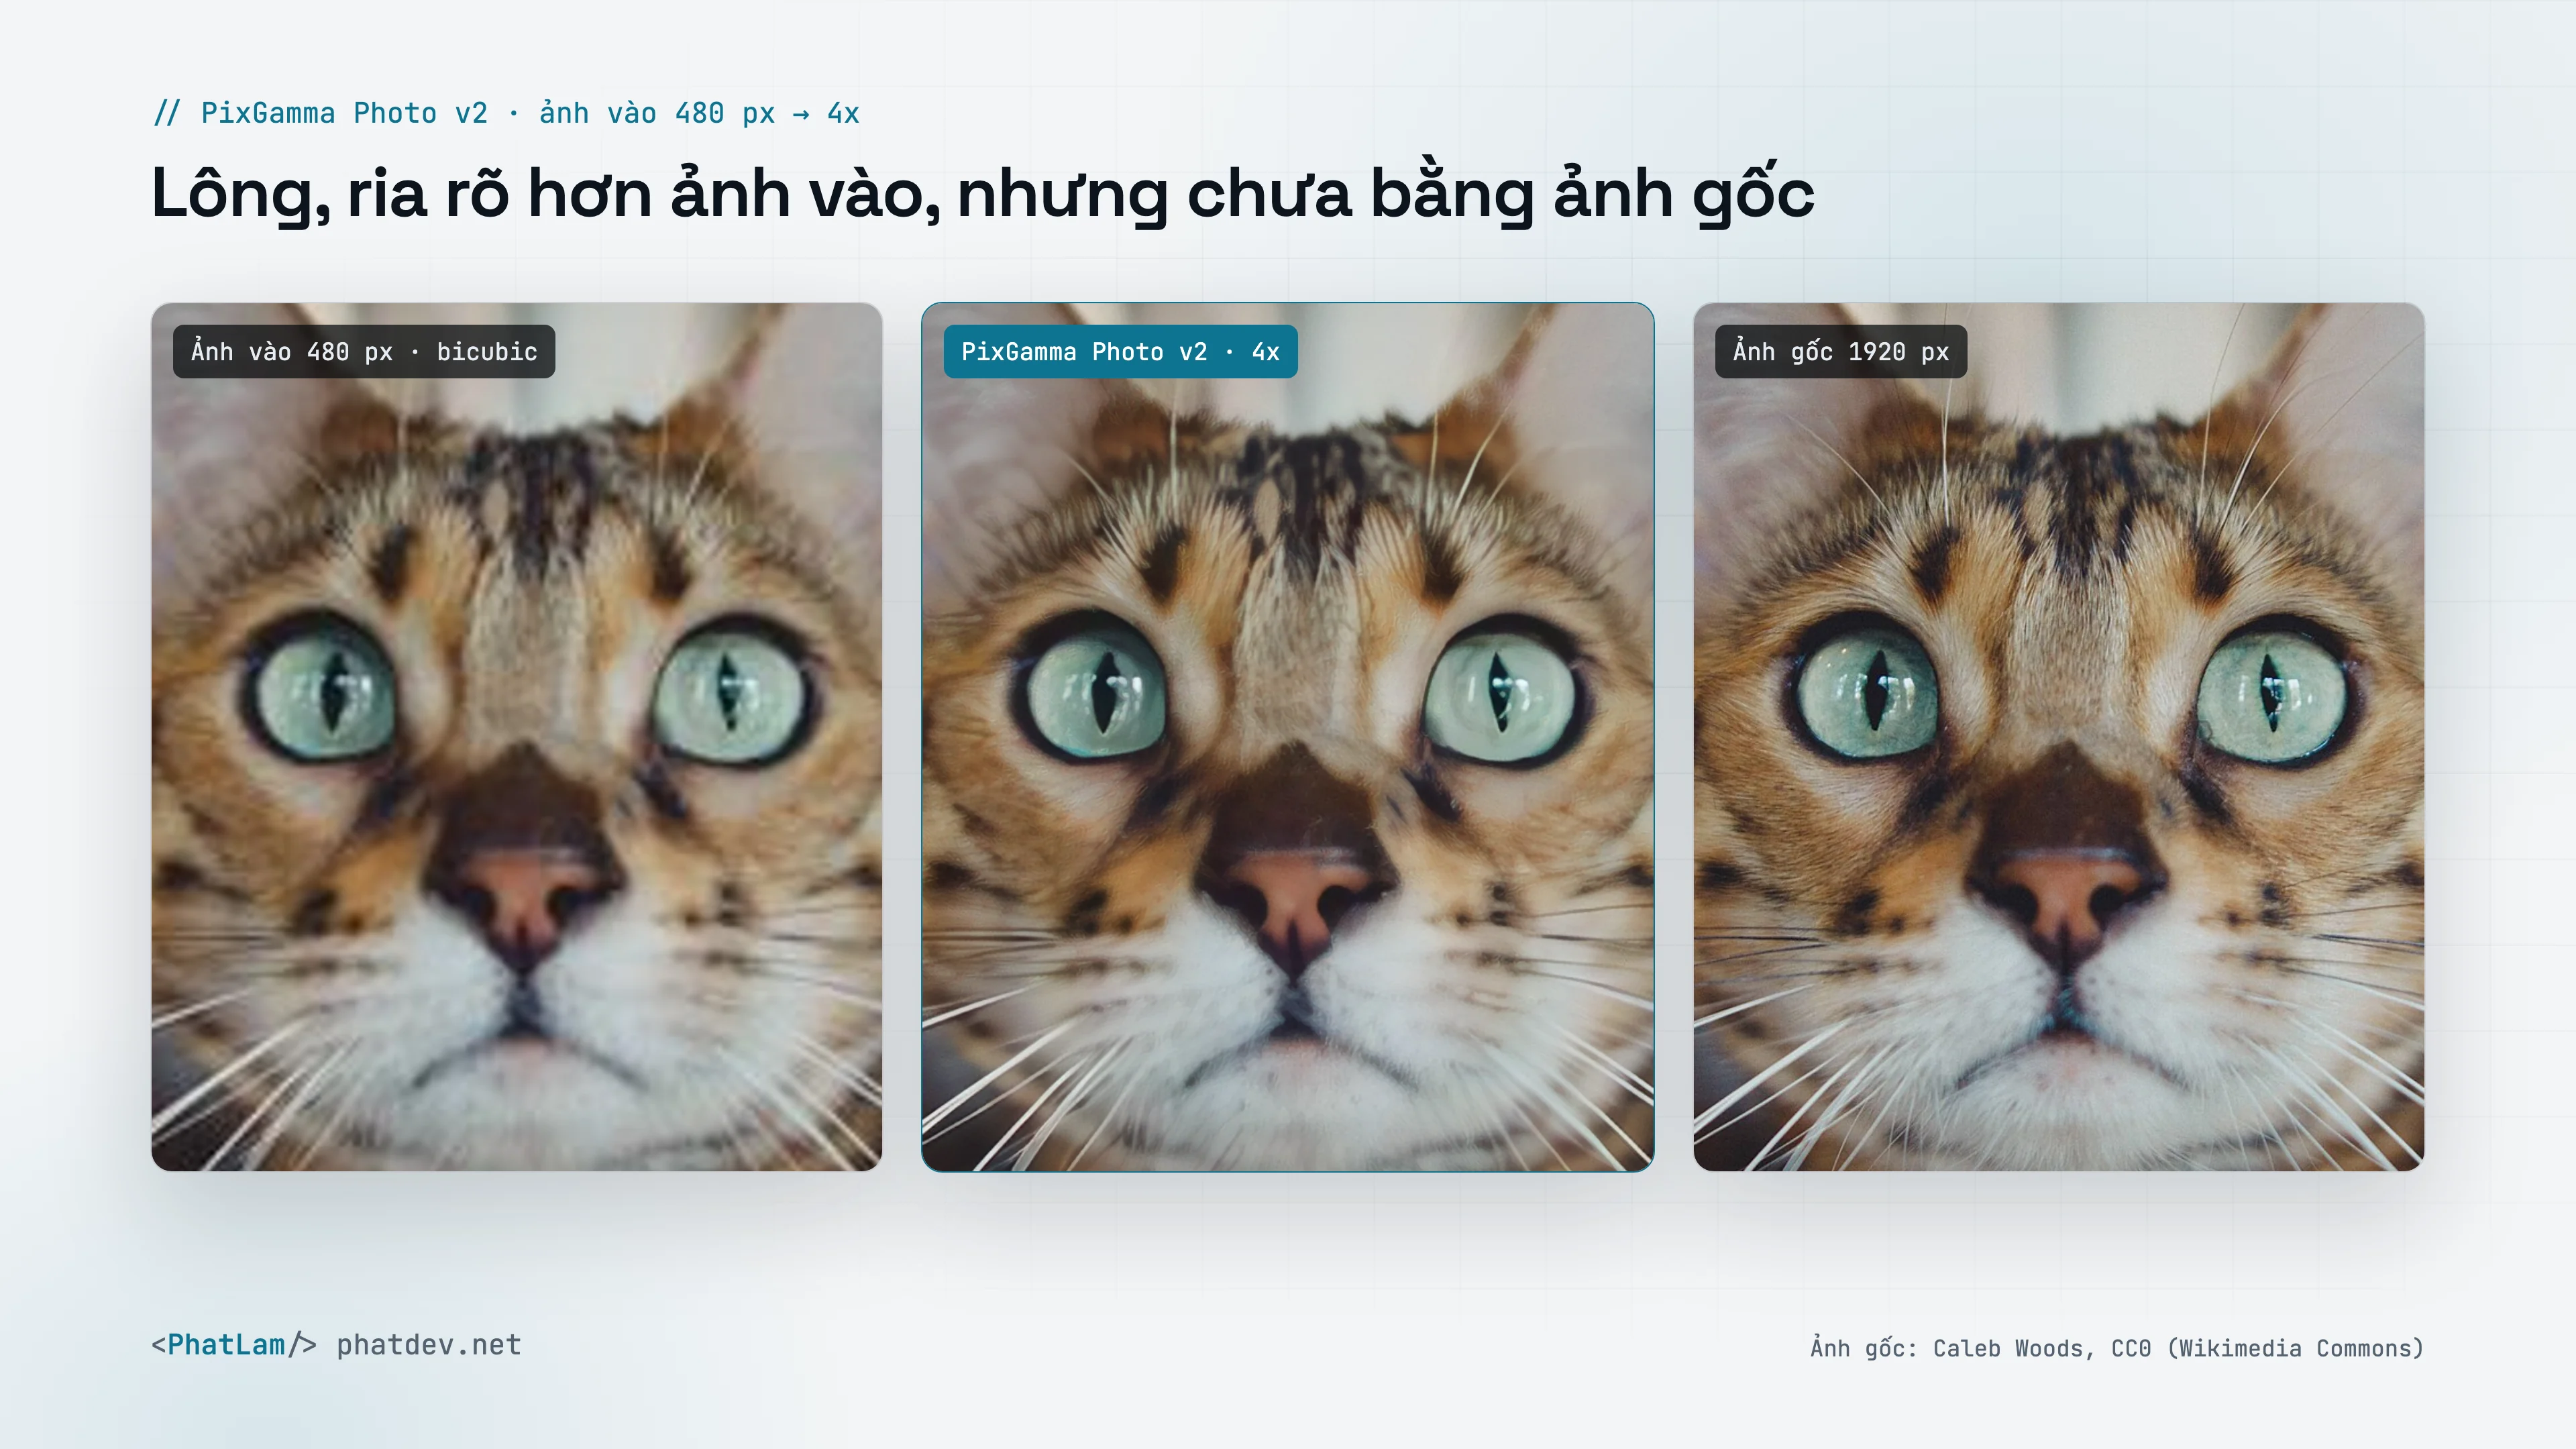
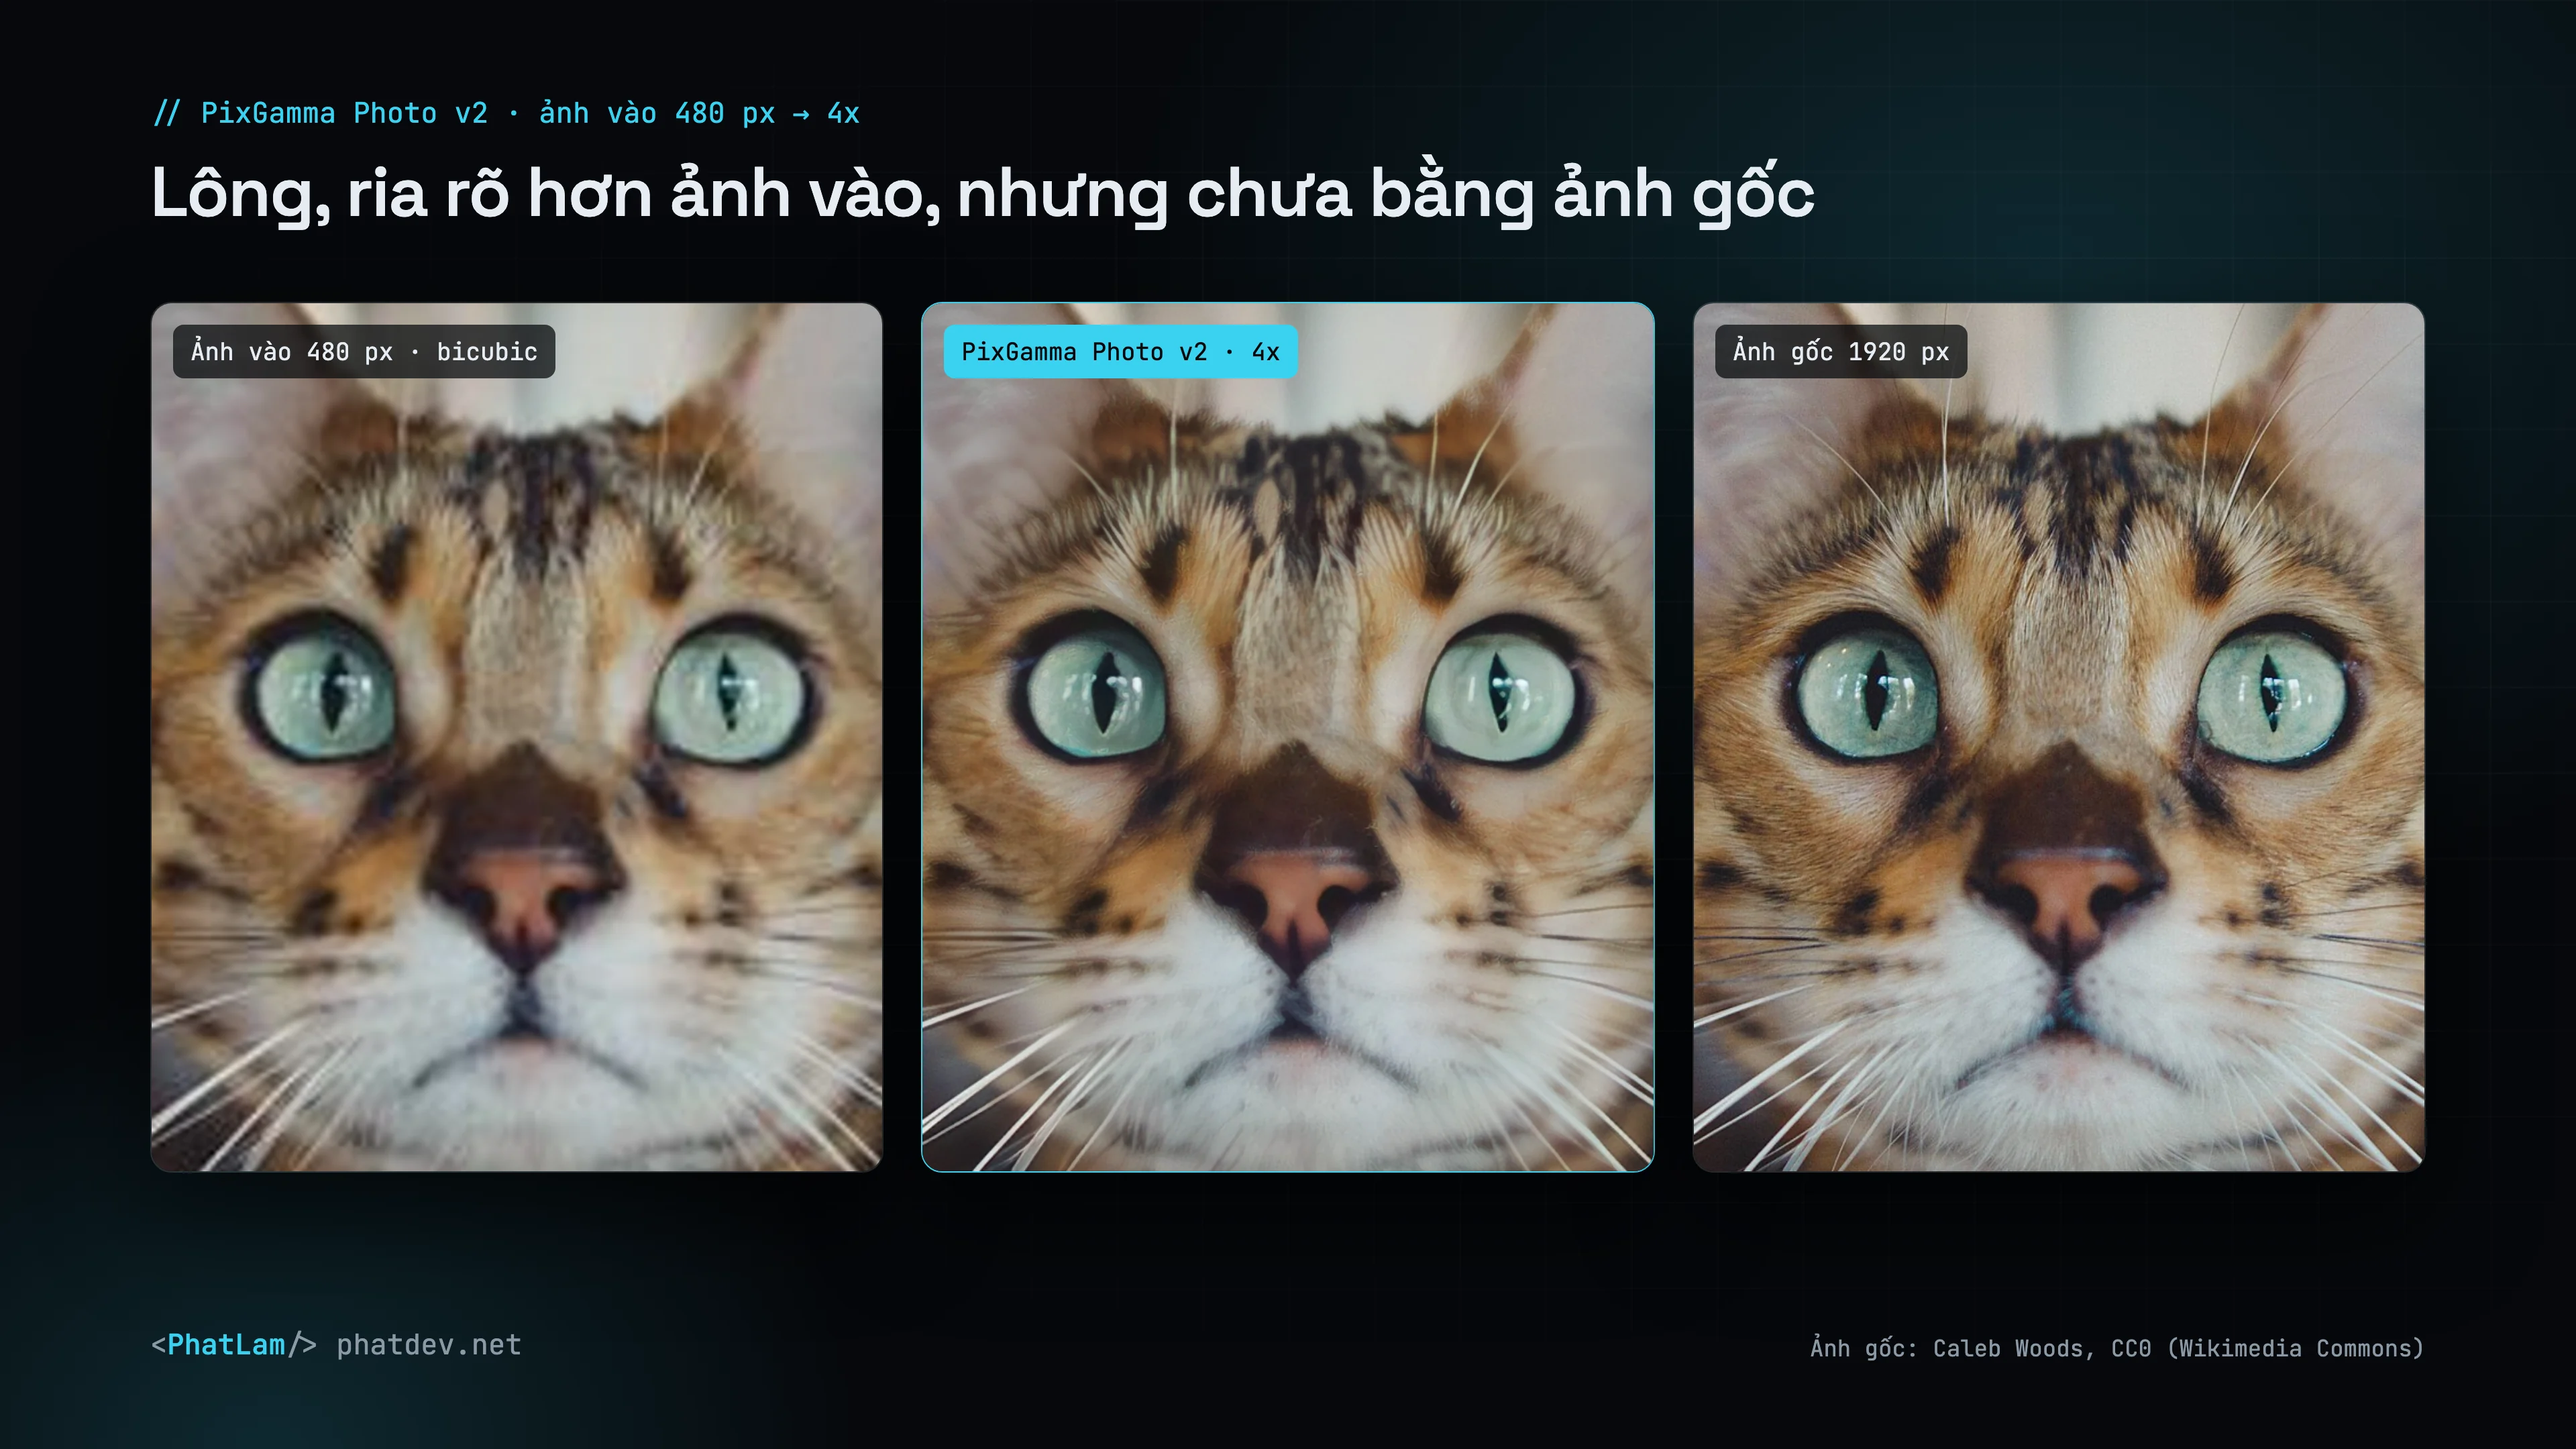
PixGamma Photo v2: mèo từ 480 px lên 4x, đặt cạnh ảnh gốc 1920 px; lông, ria rõ hơn ảnh vào nhưng chưa tách từng sợi như ảnh gốc
- Photo v1 train tiếp với **GAN nhẹ** để lông, tóc, hạt vải rõ hơn.
- DISTS trên 40 ảnh chấm: **0,164** (v1: 0,165); trên ảnh sắc nét: **0,170** (v1: 0,183).
- **Vùng chữ vẫn dùng Photo v1** (không GAN), nên GAN không bao giờ vẽ nét chữ.
- Vòng 2 với GAN mạnh hơn chấm kém hơn nên không dùng.
- Photo v2 là model 4x; phóng 2x vẫn dùng SPAN.
## PixGamma Photo v1
- Kiến trúc **DAT2**, fine-tune 15.000 vòng từ 4xBHI_dat2_real (Philip Hofmann, CC-BY-4.0).
- Dữ liệu: ảnh CC0 và public domain từ Wikimedia Commons, đã lọc tranh vẽ và ảnh nhạy cảm, bỏ ảnh dùng để chấm. Một nửa ảnh nhỏ làm bằng **chuỗi thu nhỏ + nén JPEG hai lần** như ảnh web; thêm 2.500 ô chữ tự sinh để không làm vỡ nét chữ.
- Loss: Charbonnier, MS-SSIM (giữ đúng điểm ảnh), LDL (chặn vệt giả), focal frequency (giữ tần số cao), DISTS (kết cấu thật). **Không dùng GAN**, để model không bịa vân.
- Kết quả: DAT2 gốc làm ảnh sáng lên khoảng 1 mức xám và ngả màu ở vùng tối; v1 gần như không lệch màu.
## Những bản đã thử nhưng không dùng
| Bản | Thử gì | Vì sao không dùng |
|---|---|---|
| Photo v2 bản đầu (0.2.1) | v1 thêm GAN nhẹ, dùng cho cả vùng chữ | Vỡ chữ nhỏ, răng cưa viền phím; bản hiện tại giữ vùng chữ cho Photo v1 |
| Photo v2 vòng 2 | GAN mạnh hơn | Chấm kém hơn bản v2 đang dùng |
| Text v4 | Model chữ thêm chữ trắng nét mảnh | Nét hơn nhưng đọc chữ hoa 4,3 px kém hơn |
| Photo v1 cho 2x | Phóng 4x rồi thu về 2x | Thua SPAN 2x trên 5/6 ảnh khi chạy cả quy trình |
## Model chữ
Bản 0.2.0 dùng model chữ riêng (RealPLKSR fine-tune từ 4xNomosWebPhoto qua 3 vòng trên chữ Việt và Anh tự sinh: 114 font có tiếng Việt, âm tiết sinh ngẫu nhiên phủ đủ tổ hợp dấu, banner, nhãn, bàn phím). Từ 0.2.1 vùng chữ chạy bằng Photo v1 vì đọc đúng hơn; model chữ vẫn nằm trong app làm dự phòng.
## Bộ công cụ
| Script | Việc |
|---|---|
| `training/fetch_commons.py` | Tải ảnh CC0, public domain từ Wikimedia Commons kèm ghi công |
| `training/prepare_dataset.py` | Cắt ô, tạo ảnh nhỏ theo chuỗi suy giảm của ảnh web |
| `training/make_text_dataset.py` | Sinh ô chữ Việt và Anh |
| `training/evaluate.py` | Chấm PSNR, DISTS, độ lệch màu |
| `training/eval_text.py`, `eval_text_pipeline.py` | Chấm chữ bằng OCR theo dòng và theo cỡ |
| `tools/convert_extra.py` | Chuyển checkpoint sang Core ML, kiểm tra sai khác so với PyTorch |
Mọi model gốc đều có giấy phép mở (CC-BY-4.0, BSD-3-Clause, Apache-2.0, MIT, OpenRAIL-M); CodeFormer chỉ dùng phi thương mại.